

# AI 爬虫疯狂抓站,拦还是不拦?别纠结了,一张策略表+几行配置说清楚
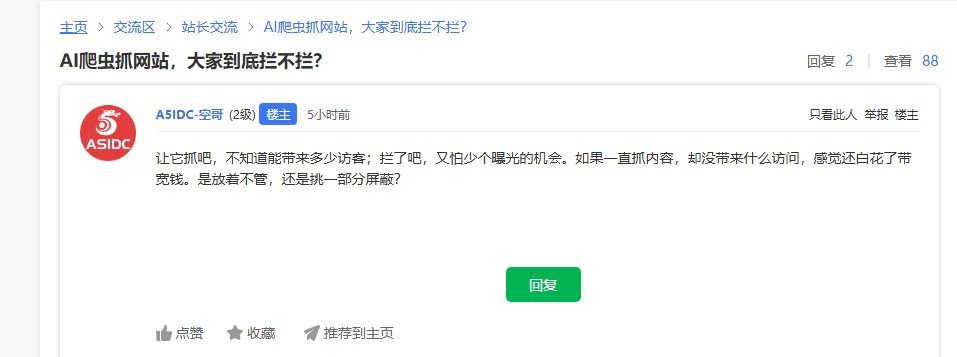
最近 A5 站长交流区有个热帖,问出了很多站长的心声:”让它抓吧,不知道能带来多少访客;拦了吧,又怕少个曝光的机会。如果一直抓内容,却没带来什么访问,感觉还白花了带宽钱。是放着不管,还是挑一部分屏蔽?”——这个问题今天给个可执行的答案:不站队,按站点类型分策略,用配置说话。
先搞清楚:谁在抓你的网站
AI 时代的爬虫分三类,性质完全不同,混在一起谈”拦不拦”没有意义:
| 类型 | 代表 | 目的 | 对你的价值 |
|---|---|---|---|
| AI 训练爬虫 | GPTBot(OpenAI)、ClaudeBot(Anthropic)、Google-Extended、Bytespider(字节) | 抓内容训练大模型 | 几乎为零:训练完不会给你引流 |
| AI 问答/引用爬虫 | PerplexityBot、OAI-SearchBot、ChatGPT-User | 实时检索并在回答中引用你的站 | 较高:回答里带来源链接,是真曝光 |
| 传统搜索爬虫 | Googlebot、Baiduspider、Bingbot | 建立搜索索引 | 核心 SEO 生命线,绝不能拦 |
关键认知:训练爬虫只索取不回报;引用爬虫至少会在答案里挂你的链接;搜索爬虫是底线。所以正确的姿势不是”全拦”或”全放”,而是区别对待。
按站点类型对号入座
| 你的站点类型 | 建议策略 | 理由 |
|---|---|---|
| 原创技术博客/教程站 | 拦训练爬虫,放引用爬虫 | 原创内容是核心资产,不能白喂模型;引用曝光要保留 |
| 电商/业务站 | 拦所有 AI 爬虫 | 产品页被抓走没有价值,还拖慢服务器 |
| 论坛/UGC 社区 | 拦训练爬虫,严控频率 | 内容是用户贡献的,无权拿去训练 |
| 企业官网(几页) | 可以放 | 内容量小,带宽压力可忽略,曝光优先 |
| 新闻/资讯站 | 优先谈合作,没条件就拦训练放引用 | 头部媒体可加入 OpenAI/Google 的内容授权分成计划 |
主机吧这类技术博客 + 资讯站,属于第一类的典型:拦训练爬虫、放引用爬虫、保搜索爬虫。
落地配置一:robots.txt(软限制)
在网站根目录的 robots.txt 里加:
# 拦截 AI 训练爬虫
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Bytespider
Disallow: /

User-agent: CCBot
Disallow: /

# 放行 AI 引用爬虫(不写 = 默认允许,写明白更稳)
User-agent: PerplexityBot
Disallow: /wp-admin/

User-agent: OAI-SearchBot
Disallow: /wp-admin/

# 搜索爬虫正常放行
User-agent: Baiduspider
Disallow: /wp-admin/

User-agent: Googlebot
Disallow: /wp-admin/

Sitemap: https://www.zhujib.com/sitemap.xml必须知道的局限:robots.txt 是”君子协定”,遵守与否全看爬虫自觉。AI 公司的主流爬虫会遵守,但大量伪装成 Chrome 浏览器的野爬虫不会。所以还需要第二层硬拦截。
落地配置二:Nginx 硬拦截(服务器层)
在 Nginx 站点配置的 server {} 块里加(宝塔用户:网站 → 设置 → 配置文件,加在 server_name 下方):
# ===== AI 训练爬虫 UA 硬拦截 =====
map $http_user_agent $block_ai_crawler {
    default 0;
    ~*GPTBot              1;
    ~*ClaudeBot           1;
    ~*Claude-Web          1;
    ~*CCBot               1;
    ~*Bytespider          1;
    ~*Google-Extended     1;
    ~*anthropic-ai        1;
    ~*PerplexityBot       0;  # 引用爬虫,放行
    ~*OAI-SearchBot       0;  # 引用爬虫,放行
}

server {
    # ...原有配置...

    if ($block_ai_crawler) {
        return 403;
    }
}
注意:
map必须放在http {}块内、server {}块外(宝塔用户可放/www/server/nginx/conf/nginx.conf的 http 块里,或用”自定义伪静态”简化写法)。改完nginx -t测试通过后nginx -s reload生效。
落地配置三:频率限制(防野爬虫刷流量)
对付伪装 UA 的爬虫,用 Nginx 的 limit_req 按IP限速:
# http {} 块内
limit_req_zone $binary_remote_addr zone=perip:10m rate=10r/s;

# server {} 块内,location 中引用
location / {
    limit_req zone=perip burst=20 nodelay;
    # ...原有逻辑...
}
单 IP 超过每秒 10 个请求就排队/拒绝,正常访客完全无感,爬虫直接被掐。想看谁在偷抓,加一行日志即可:
# 查看抓取最频繁的 UA
tail -n 100000 /www/wwwlogs/你的站点.log | awk -F'"' '{print $6}' | sort | uniq -c | sort -rn | head -20
三个常见误区
误区一:拦了 AI 爬虫 = 拦了所有曝光。 错。搜索爬虫(百度/Google)和 AI 引用爬虫(Perplexity/OAI-SearchBot)都还放行着,搜索引擎排名和 AI 回答引用两个入口都没丢。真正被拦的只是”白吃你内容去训练模型”的那部分。
误区二:robots.txt 一劳永逸。 它挡不住伪装 UA 的爬虫。带宽被刷爆的站点,八成是只配了 robots.txt 没上 Nginx 硬拦截。
误区三:所有 AI 爬虫都该杀光。 Perplexity 这类引用型爬虫带来的曝光是新流量入口——AI 时代的”搜索排名”正在变成”AI 回答引用位”。如果你的内容被 Perplexity 引用,点击是真实存在的。把它们和训练爬虫一起拦掉,等于把新渠道也关了。
回到那个问题:放着不管,还是挑一部分屏蔽?
答案已经很清楚了:挑一部分屏蔽,而且是精确屏蔽。
– 训练爬虫 → 拦(robots.txt + Nginx 双保险)
– 引用爬虫 → 放行,这是 AI 时代的免费曝光
– 搜索爬虫 → 呵护,这是 SEO 命根
– 野爬虫 → 限速,保护带宽
这样既不用纠结”白花带宽”,也不放弃任何真实曝光渠道。花 10 分钟把上面三段配置落下去,比在论坛里纠结”拦不拦”有用得多。
*来源:A5 站长交流区讨论,配置适用于 Nginx 环境,宝塔面板同样适用。*
