

很多网站都面临自动化爬虫、无头浏览器(Playwright/Puppeteer)批量采集数据的困扰。这类爬虫依托Chromium无头模式模拟浏览器访问,抓取页面内容。我们可以借助百度云防护 WAF自定义规则,通过HTTP请求头指纹识别这类爬虫,实现基础Bot防护。
一、无头爬虫标志性Header指纹
普通真实浏览器与无头自动化浏览器,在请求头细节上存在明显差异,其中最典型特征:
- sec-ch-ua:无头浏览器默认会携带
HeadlessChrome字符串,正常桌面Chrome浏览器不会出现这个标识。 - Priority:HTTP/2协议下,无头爬虫请求经常出现
u=0,i这类Priority头,普通网民浏览器极少携带。 - sec-ch-ua-platform-version:新版真实Chrome会自带该请求头,大量无头实例直接缺失。
注意:Sec-Fetch系列请求头是现代浏览器原生自带,不可单独用来拦截,仅可作为辅助判断。
二、百度云防护 WAF规则配置思路
核心原则:禁止单条请求头直接拦截,采用多条件「且」组合,降低误杀正常访客风险
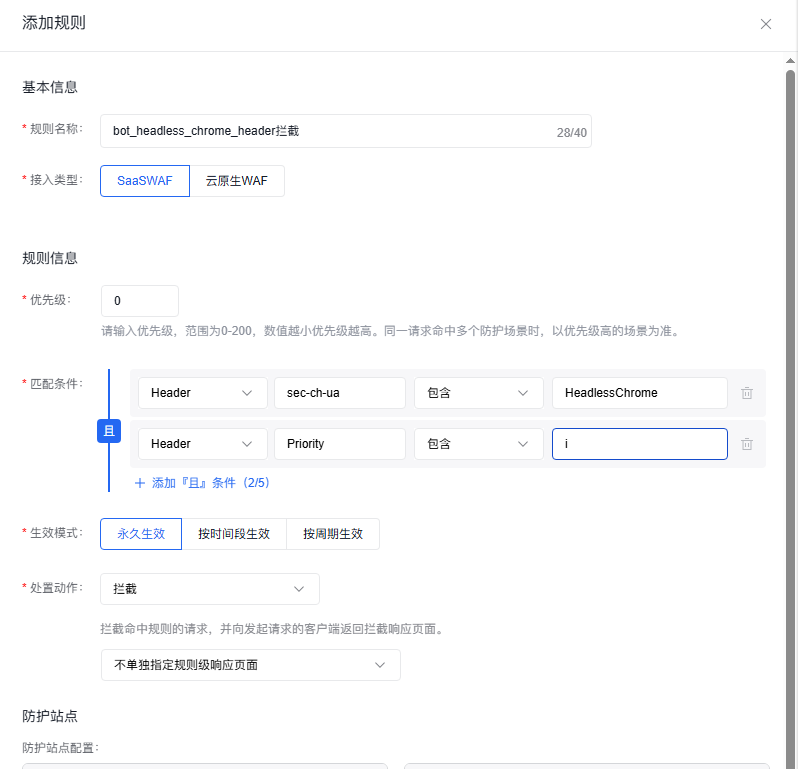
推荐生产拦截规则(SaaSWAF)
- 规则名称:bot_headless_chrome_header拦截
- 接入类型:SaaSWAF
- 优先级:10(数值越小优先级越高,不要设置0,避免干扰内置安全规则)
- 匹配逻辑:同时满足下面两个条件(且关系) 条件1:Header
sec-ch-ua包含HeadlessChrome条件2:HeaderPriority包含i - 生效模式:永久生效
- 处置动作:拦截
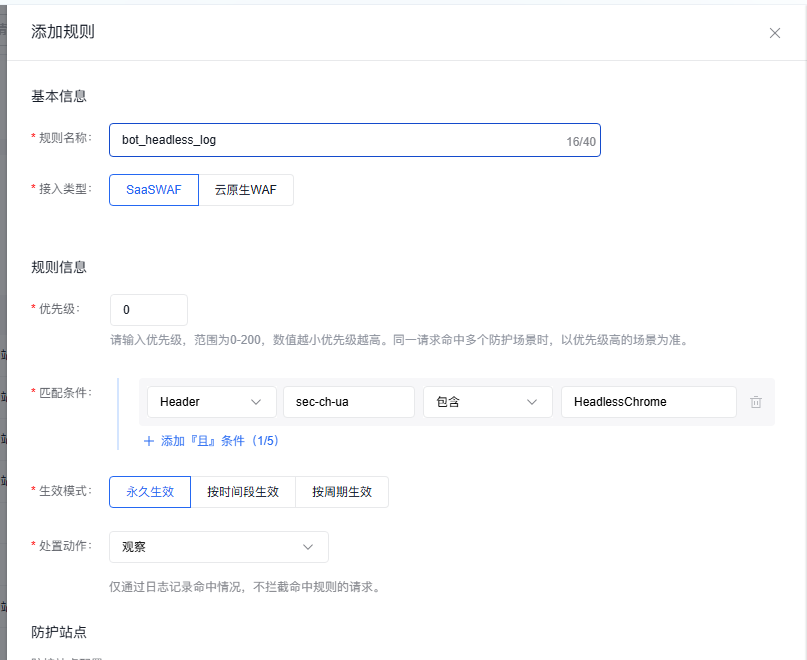
观察审计规则(上线前测试用,不直接拦截)
- 规则名称:bot_headless_log观察
- 接入类型:SaaSWAF
- 优先级:50
- 匹配条件:Header
sec-ch-ua包含HeadlessChrome - 处置动作:仅记录使用建议:新规则先设置为「观察」,观察1-3天访问日志,确认无误杀后,再切换成拦截动作。
三、实操步骤(百度WAF控制台)
- 进入WAF控制台,web防护,打开【自定义规则】→【添加规则】,选择SaaSWAF接入类型;
- 填写规则名称,设置优先级;
- 匹配条件选择Header,填入
sec-ch-ua,匹配方式选「包含」,内容填写HeadlessChrome; - 点击添加「且」条件,新增Header条件
Priority包含i; - 选择永久生效,设置处置动作,勾选防护站点,保存发布。
四、重要避坑提醒
- 请求头指纹可以被爬虫伪造,该规则只能拦截基础无头爬虫,需要搭配JA4指纹、访问频率、IP信誉、验证码等多层防护;
- 提前添加百度搜索引擎爬虫、监控拨测IP到白名单,防止误杀正规流量;
- 不要单独依靠Priority头拦截,少量正常HTTP/2客户端也会携带该请求头,必须组合HeadlessChrome特征一起判断。
五、小结
基于HTTP Header指纹的WAF规则,是网站对抗基础无头爬虫成本最低的第一道防护。多条件组合策略可以平衡防护效果与误杀风险,适合中小站点快速落地爬虫防护。
很多站长会担心:百度、谷歌这类搜索引擎渲染蜘蛛同样基于 Chromium 无头内核,会不会命中 HeadlessChrome 规则被误拦?答案是不会。 正规搜索引擎爬虫虽然使用 Chromium 内核解析 JS 页面,但厂商会在内核层面定制处理,清除HeadlessChrome指纹标识,不会在sec-ch-ua中出现该字符串。 只有第三方 Playwright、Puppeteer 开发的采集爬虫,默认配置才会携带 HeadlessChrome。 注意:有不少恶意爬虫会伪造 Baiduspider 的 UA 冒充搜索引擎蜘蛛,这类假冒爬虫反而大概率会保留 HeadlessChrome 指纹,会被我们的 WAF 规则识别拦截。
