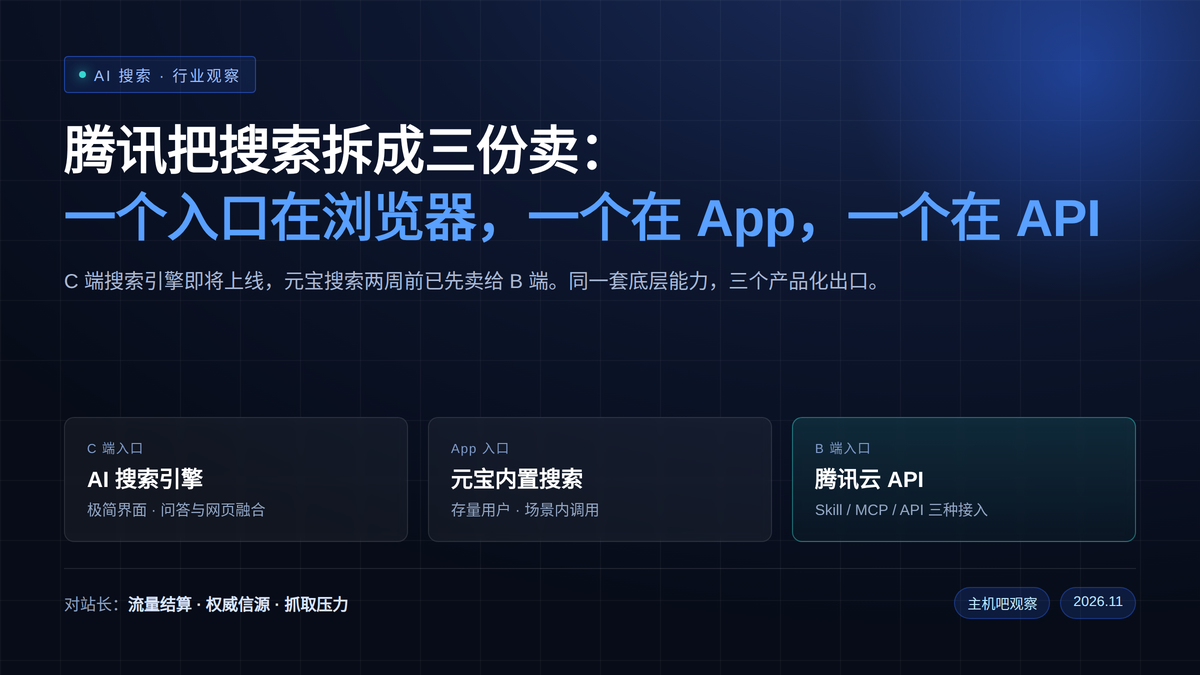

11 月 3 日,IT 之家援引虎嗅的报道称,腾讯即将发布一款面向 C 端用户的 AI 搜索引擎:界面极简、全面 AI 化、强化权威信源排序,并且会把 AI 问答与网页搜索「揉进同一个体验里」。
更值得注意的时间点是:就在两周前,腾讯已经把「元宝搜索」(前身是联网搜索)卖给了 B 端客户。这套能力在腾讯内部低调跑了几年,这是第一次对外变现。
做了十几年搜索、始终没在 C 端撕开口子的腾讯,为什么选在这个时间点回到浏览器首页?答案可能不在搜索框里。
一、三个入口,一套底层
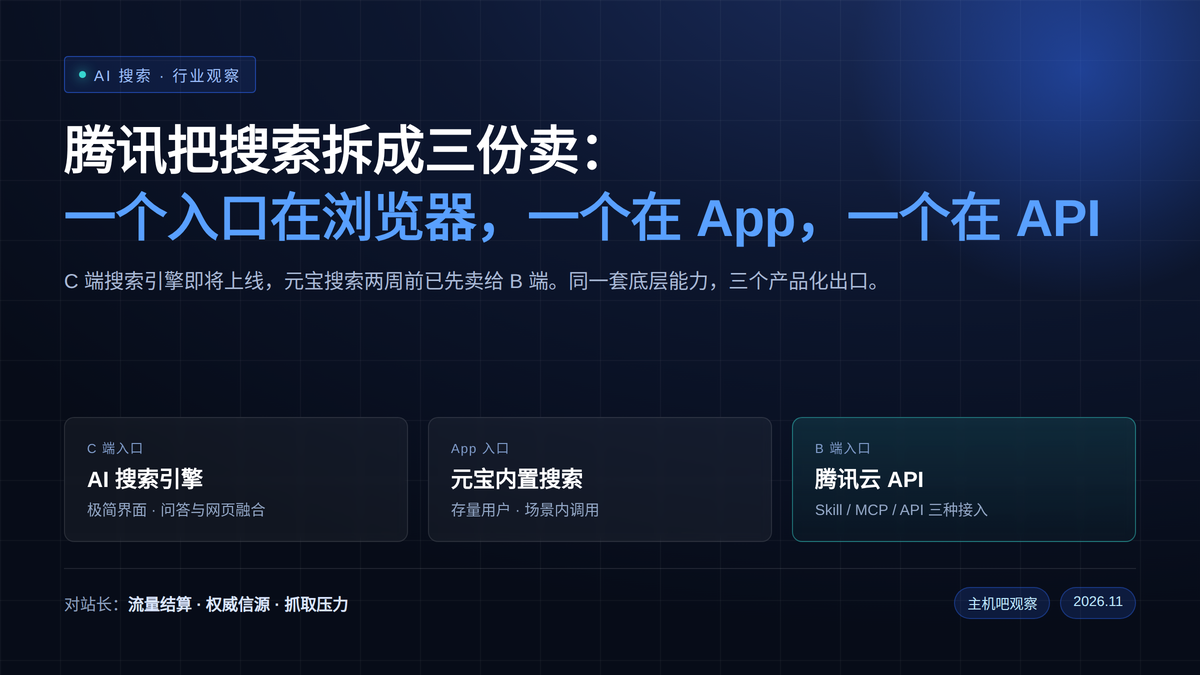
据腾讯内部人士的说法,即将上线的 C 端搜索引擎、元宝 App 内置搜索、腾讯云「元宝搜索」API,共享同一套底层能力——面向浏览器与网页搜索场景时,三者本质上是同一套能力在不同入口下的产品化呈现。
换句话说,腾讯这次不是从零做一个新产品,而是把一套已经跑了几年的能力,拆成三个出口同时开卖。
- C 端 AI 搜索引擎:极简界面,AI 问答与网页结果融合,面向普通用户。
- 元宝 App 内置搜索:场景内调用,面向存量 App 用户。
- 腾讯云「元宝搜索」:Skill / MCP / API 三种接入,面向开发者与企业。
B 端这边已经有明确的开卖方式:凭邀请码在 10 月、11 月最高可调用 6000 次;接入流程也不复杂——在腾讯云拿到 API Key,打开终端敲一条 curl 就能发起请求。
二、为什么是现在:搜索正从「入口」变成「水电」
报道里给了一个很实在的背景:百度稳坐国内搜索头把交椅已经超过二十年。腾讯这十几年兜兜转转——做过 SOSO、收购搜狗、上线微信搜一搜、再到元宝 App,始终没在 C 端撕开实质性缺口。
硬碰搜索框赢不了,那就换一个战场。Agent 这波起来之后,搜索的形态变了:它不再只是用户主动打开的一个页面,而是所有 AI 应用背后的底层调用。标准化搜索 API 的需求在快速扩容,而「谁提供这个 API」和「谁的搜索首页更好用」,本来就是两套完全不同的竞争逻辑。
元宝搜索团队 2024 年年中与元宝 App 同步组建,整合了 QQ 浏览器、搜狗搜索的核心技术基因——腾讯十几年的搜索算法与工程积累,被重构成一套面向 AI 时代的搜索基础设施。
这也解释了为什么先卖 B 端:Agent 场景里的调用量是刚性的、可计费的,而 C 端搜索要先抢用户习惯。先赚确定的钱,再争不确定的入口。
截至发稿,腾讯官方对上述传闻暂无回应(据新浪科技报道)。
三、对站长,这件事有三层影响
1. 流量结算方式,又要变一次
「AI 问答与网页搜索揉在同一体验里」,意味着用户可能在结果页就把问题解决了,不一定再点进你的站。这未必全是坏消息——如果它保留网页结果位,被引用的站点反而能拿到高意向曝光。但「搜索点击 → 落地页 → 广告」这条老链路,会继续被压缩。
2.「权威信源」成了新的排名维度
报道里明确提到「强化权威信源排序」。这句话对内容站的含义很直接:AI 搜索要引用你,先得判断你可信。原创度、作者与站点资质、内容可溯源、结构化标记(JSON-LD 里的 Article、FAQPage、HowTo),这些过去算「加分项」的东西,正在变成「入场券」。
3. 抓取压力会实打实落在服务器上
多一个搜索入口,就多一套爬虫。AI 搜索要建索引,抓取频率和深度通常比传统搜索更激进——最先感受到的往往不是排名变化,而是 CPU 曲线和 5xx 错误。中小站带宽小、PHP 进程池浅,一轮高频抓取就能把站点打到 502。
四、主机吧的建议:先把手里的服务器准备好
- 给 AI 爬虫分级,别一刀切。训练类限速、索引类放行、代取类按需,这三档的处理方式完全不同,混在一起拦只会误伤自己的收录。具体拆法见我们之前那篇《AI 爬虫分三档,百度云防护 WAF 怎么分级拦》。
- 放行条件要绑 IP 段,不能只认 UA。只按 User-Agent 放行的白名单,攻击者伪造一个 Baiduspider 的 UA 就绕过去了,等于给全站开了免检通道。
- 抓取峰值的 5xx,先查进程池和回源。很多 502 不是带宽不够,而是 PHP 进程池打满或回源超时,盲目加带宽只是多花钱。
- 把内容结构化,讲给机器听。JSON-LD、清晰的小标题层级、可溯源的信息来源,是「权威信源」这条新维度上少数能主动做的功课。
- 源站别裸奔。搜索爬虫变多,扫描器也会跟着变多。云防护加回源 IP 白名单,是成本最低的一条底线。
五、写在最后
腾讯这次能不能在 C 端站住,现在看不清。但有一件事比较确定:搜索的入口在变多,每一个入口背后都是一轮抓取。
流量账要重算,服务器账单也会跟着变。对中小站来说,与其赌哪家搜索赢,不如先把「被找到」和「扛得住」这两件事做扎实——前者靠内容和结构,后者靠防护和带宽。
本文事实部分综合 IT 之家、虎嗅、新浪科技报道整理,观点部分为主机吧观察。