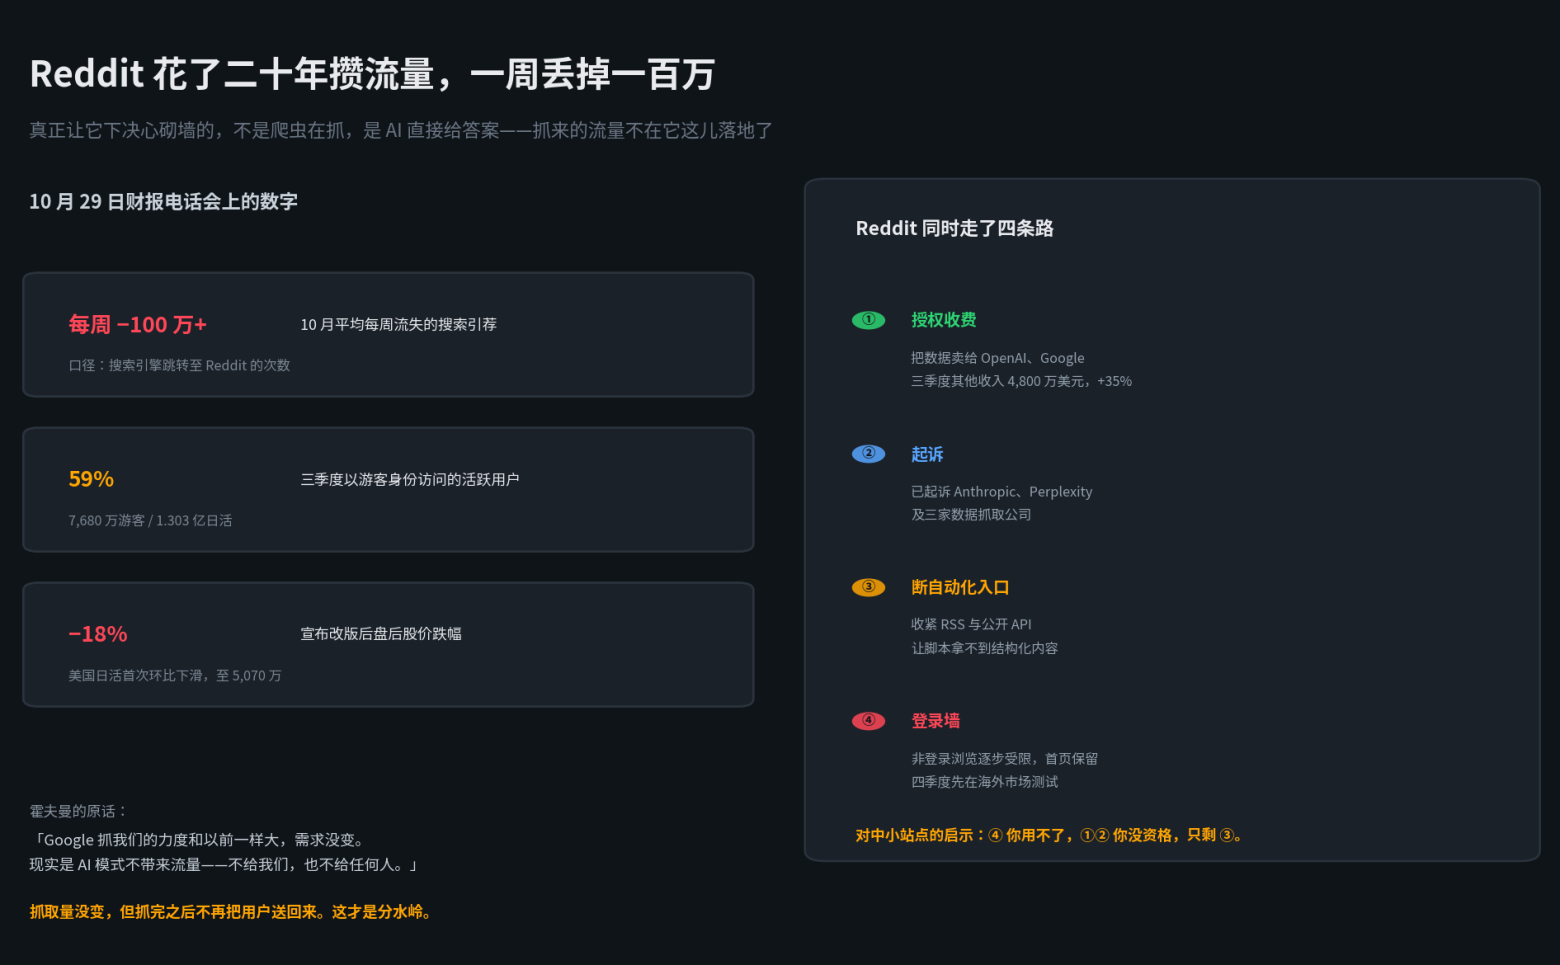

10 月 29 日,Reddit 公布了 2026 年第三季度财报。营收 8.95 亿美元、同比增长 53%,净利润 2.83 亿美元——数字很漂亮。但同一场电话会上,CEO 史蒂夫·赫夫曼(Steve Huffman)宣布了一件改变这个网站二十年形态的事:Reddit 将逐步转向以登录浏览为主。
这个从 2005 年上线起就允许游客自由浏览的社区,要开始砌墙了。
官方的理由列了三条:个性化推荐、广告定向、用户活跃度。但赫夫曼把它排在了最后,也说得最直白——阻止 AI 模型爬取站内内容。
消息出来,盘后股价跌了 18%。
一、真正让他下决心的,不是「被抓」,是「抓完不还」
很多人把这件事读成「Reddit 受不了 AI 爬虫了」。这个理解漏掉了最关键的一层。
赫夫曼在电话会上说了两句很值得琢磨的话:
「Google 抓我们的力度和以前一样大,所以从他们的角度看,需求也没变。现实是,AI 模式不带来流量——不给我们,也不给任何人。」
他还给了一个很硬的数据:10 月里,搜索引擎跳转至 Reddit 的次数,平均每周减少超过 100 万次。

这两句话合起来,才解释了整件事:爬虫一直在抓,这件事本身 Reddit 忍了二十年。真正变的是抓完之后的结果——以前搜索引擎抓完还给一个跳转链接,用户点进来,看到广告;现在 AI 直接在回答里把内容消化掉,用户不用来了。
所以 Reddit 面对的不是「爬虫问题」,是流量结算方式变了。
二、Reddit 能砌墙,你砌不了
面对这个局面,Reddit 同时走了四条路,而且四条都有底气:
- 授权收费。把数据卖给 OpenAI 和 Google。三季度「其他收入」(主要就是数据授权)4,800 万美元,同比增长 35%。
- 起诉。已起诉 Anthropic、Perplexity,以及三家数据抓取公司,指控其非法收集 Reddit 数据。
- 断自动化入口。收紧 RSS 与公开 API,让脚本拿不到结构化内容。
- 登录墙。非登录浏览逐步受限,首页保留公开,四季度先在海外部分市场测试。
这四条里,第 3 条和第 4 条是「堵」,第 1 条和第 2 条是「收」。堵是为了让收变得有意义——如果谁都能随便抓,那授权就一文不值。
现在把镜头拉回你自己的站。
你的站没有 1.3 亿日活,没有议价权,起诉一家 AI 公司的律师费可能比全年广告收入还高。登录墙?你的读者大多是从搜索结果点进来的一次性访客,让他们先注册,等于直接关门。
四条路你只剩第三条:把自动化入口管住。这也正是这篇要讲的全部内容。
三、AI 爬虫不是一个身份,是三档诉求
这是最多人栽跟头的地方。几乎所有教程都教你「在 robots.txt 里 Disallow GPTBot、CCBot、ClaudeBot」,然后配一条 UA 拦截规则全拦——这是拿关键词一把梭,会连自己人一起打。
先看清一件事:同一家 AI 公司会派好几个不同的爬虫来,各干各的。OpenAI 至少有 GPTBot(训练)、OAI-SearchBot(索引)、ChatGPT-User(用户当场贴链接时代取)三个;Anthropic 有 ClaudeBot、Claude-SearchBot、Claude-User;Perplexity 有 PerplexityBot 和 Perplexity-User。

第一档,训练。代表是 GPTBot、ClaudeBot、CCBot、Bytespider、meta-externalagent。它把内容存进训练语料,变成未来模型的一部分。抓走就抓走了,不会有任何回访。这档拦掉,你损失的是一点点带宽,换来的是干净的日志。
第二档,索引。代表是 OAI-SearchBot、PerplexityBot、Claude-SearchBot。它把你的页面编进 AI 搜索的索引,在回答里引用你、给出处链接。这档的点击是真实存在的,虽然量级远不如传统搜索。拦掉它,等于放弃一个还在长的新渠道。
第三档,代取。代表是 ChatGPT-User、Claude-User、Perplexity-User。它不是自行爬取,是用户当场在对话里贴了你的链接,它即时来取一次。这相当于一个真人正在看你的页面——只是借了 AI 的手。
第三档是最容易被误伤的。你按 UA 关键词「Bot」批量拦截,或者按 IDC 规则一刀切,很可能把正在读你文章的读者一起挡在门外。而他看到的不是「被拦截」,是一句莫名其妙的 403。
四、robots.txt 管不住它,这才是要上 WAF 的原因
有人会问:我在 robots.txt 里写清楚不就行了?
问题在于,robots.txt 是一份没有强制力的君子协定。它依赖爬虫自己读了并且愿意遵守。对守规矩的厂商有效,对不守规矩的无效——而这个「不守规矩」的名单并不短:Bytespider 的合规性长期存在争议,Perplexity 在 2024 年被调查报道指出无视 Disallow 规则,Common Crawl 的态度则是「变量」。
更要命的是第三档那些「用户触发型」爬虫,多数厂商在文档里就明说:这类请求可能不受 robots.txt 约束,因为背后有个真人正在等着答案。
所以真正管用的结构是两层:
| 层级 | 手段 | 管什么 | 局限 |
|---|---|---|---|
| 软限制 | robots.txt | 声明立场,约束守规矩的爬虫 | 无强制力,违规者照抓 |
| 硬拦截 | WAF / 反向代理规则 | 不管它遵不遵守,一律按你的规则处置 | 需要识别能力,配错会误伤 |
软限制表态度,硬拦截才真正管用。而硬拦截做得好不好,取决于一件事:你能不能准确区分这三档。只靠 UA 字符串是分不准的——UA 谁都能伪造,一条 curl -A "Googlebot" 就能冒充搜索引擎。
五、百度云防护 WAF 怎么接这段活
这里才是本文的重点。下面说的都是控制台里真实存在的配置,路径是:控制台 → Web应用防火墙 → 防护配置 → Bot管理 → 创建 Bot 规则模板。
百度云防护 WAF 的 Bot 管理里,四项能力各自负责一个角度,刚好能对上前面说的三档:

第一层:基础特征库——先把「谁来了」认出来
这一层分四组规则:搜索引擎规则、UA 规则、IDC 规则、IP 情报。
最要紧的是搜索引擎规则。它专门识别百度、谷歌等正规搜索引擎蜘蛛并放行,是保住 SEO 基本盘的那道保险。这条规则务必保持开启——很多站长配防爬虫配到最后收录掉了一半,就是这里没设好。
UA 规则是分场景的,不是一刀切。这一点很关键:它对通用采集爬虫、垃圾爬虫、漏洞扫描工具直接拦截;对翻译类爬虫只给 JS 挑战;对广告验证类爬虫用滑块验证。为什么不能全拦?翻译爬虫拦了,海外用户就翻译不了你的页面;广告验证爬虫拦了,广告联盟可能判你作弊。
IDC 规则识别云服务商和 IDC 的 IP 段。这条对 AI 爬虫特别有效——爬虫要规模化,基本都跑在云服务器上,真实用户极少从 IDC IP 正常访问你的站。
IP 情报是基于百度安全大数据的综合风险 IP 库。爬虫就算伪造了 UA、控制了频率,只要它用的 IP 有前科,照样能识别出来。
第二层:AI 智能防护——不认标签,认行为
这一层是把请求分成四类:恶意 Bot、疑似 Bot、友好 Bot、正常请求,每一类可以单独配处置动作。
它的价值和第一层完全不同。第一层靠「你是不是自称某个爬虫」,第二层靠「你的行为像不像人」——不需要固定规则,持续学习站点的正常流量基线。请求完全合法、UA 也不可疑,但如果某个接口在极短时间内收到大量来源分散、指纹熵值异常升高的请求,AI 引擎可以判定这是自动化行为。
对本文的场景,这一层的用法是:「恶意 Bot 请求」设为滑块验证或拦截,「疑似 Bot 请求」先设观察。官方给的建议也是这样——疑似类先观察,确认没有误拦截再逐步收紧。
第三层:客户端画像分析——查这个 IP 的出身
它按源 IP 的近期行为打标签,分五类风险:网络代理、攻击威胁、恶意爬虫、异常操作、非正常设备,每类再按置信度分高、中、低三档。
代理池和秒拨 IP 在这一层会现形。爬虫规模化运行几乎必然挂代理,而「这个 IP 最近是不是在批量爬别人家网站」这种判断,光看你自己的日志是做不出来的——得靠安全厂商的全局数据。
配置思路上,高风险档才处置,中低置信度默认不动作。这个「按确定性分档出手」的设计比一刀切靠谱得多,因为误伤一个真实用户的代价,往往比放过一个爬虫大。
第四层:自定义规则 + JA3/JA4——对付顽固的那批
前面三层都失效的时候,还有最后一招。
AI 爬虫工具可以换 IP、改 UA、控制频率,但有一样东西很难改:TLS 握手指纹。同一个抓取框架,无论换多少 IP、伪装成什么 UA,JA3/JA4 指纹基本不变。
百度云防护支持在自定义规则里直接匹配 JA3/JA4 指纹。做法是从攻击日志里提取那个爬虫的指纹,填进规则,处置动作选拦截。一条规则封掉所有换 IP 的尝试,这是按 IP 封禁完全做不到的。
动作别只会用「拦截」
这套系统提供的不止「拦截」一个动作,常用的有五个:
- 观察——只记录不处置。摸清站点 Bot 构成阶段必用。
- 滑块验证——给一次人机验证机会。拦住机器,给可能的真人留了通道,误杀率低。
- 严格滑块验证——连续挑战,对付会过普通滑块的。
- 拦截——确认恶意才用,直接返回 403。
- 回源标记——放行但加标记,交给业务侧做进一步判定。
「滑块验证」这个档位在实际使用中比「拦截」更值得推荐。对第三档那种用户触发的爬虫,直接 403 会让一个真读者看到莫名其妙的错误页;给个滑块,真人一秒过,机器过不去,两边都不吃亏。
六、给中小站点的上线路径
直接说结论,一条能照着走的路径:
- 第一步,先开「观察」跑三到七天。AI 智能防护和客户端画像的各档全部设观察,只记录不处置。目的很单纯:先搞清楚自己站上到底有哪些 Bot、各占多少。
- 第二步,锁死搜索引擎规则。确认搜索引擎规则处于启用且放行状态。这一条不做,后面所有动作都有风险。
- 第三步,训练档收紧。把训练档的 UA(GPTBot、CCBot、Bytespider 等)配成拦截或滑块验证。这档拦错成本最低。
- 第四步,索引档只限频,不拦。OAI-SearchBot、PerplexityBot 这类,用频率限制控制抓取压力就够了。它们抓得再多,也在给你带曝光。
- 第五步,代取档务必放行。ChatGPT-User、Claude-User、Perplexity-User 这类不要拦。拦了就是在挡正在访问的真人。
- 第六步,顽固的封指纹。前面都拦不住的,从日志里提 JA3/JA4 指纹,一条规则解决。
另外提醒一句:Bot 管理是 SaaS WAF 企业版才有的功能,基础版看不到这个入口。如果你的站目前是免费版或基础版,只能先用 robots.txt 加 Nginx 层的 UA 规则顶着——效果有,但挡不住伪造 UA 的。
七、写在最后
Reddit 这场改版,最值得国内站长琢磨的不是「登录墙」这个动作,而是它对形势的判断:AI 时代的爬虫问题,本质是流量结算问题,不是技术问题。
Reddit 有能力把「被抓」变成「被付费」。它手上有独家内容、有 1.3 亿日活、有律师团队,谈得动授权,也打得赢官司。所以你看到它砌墙,不必急着学——它砌墙是有底气的,你砌墙是把读者推走。
中小站点能做的,是把同一件事做在更早的一环:不是阻止被抓,而是决定谁抓、抓多少、抓到什么。训练档不给,索引档少给,代取档照给——这个分层本身就是一种定价,只不过你收的不是钱,是带宽和注意力。
至于具体怎么落地,前面写过几篇可以对着看:AI 爬虫疯狂抓站,拦还是不拦讲的是按站点类型做策略取舍;百度云防护 WAF Bot 管理功能更新是这套模块的逐个拆解;利用 WAF 识别无头爬虫讲的是请求头指纹怎么抓。如果你的站正被 AI 爬虫压得 CPU 打满,先按第五节的顺序配一遍,比急着上高防划算。
资料来源:IT之家 2026 年 10 月 30 日报道(原文)、Reddit 2026 年第三季度财报与股东信、路透社 10 月 29 日报道、百度智能云 WAF 官方文档《Bot 防护最佳实践》(2026 年 10 月 13 日更新)。文中 UA 标识以各厂商公开文档为准,厂商可能随时调整,配置前建议核对最新说明。