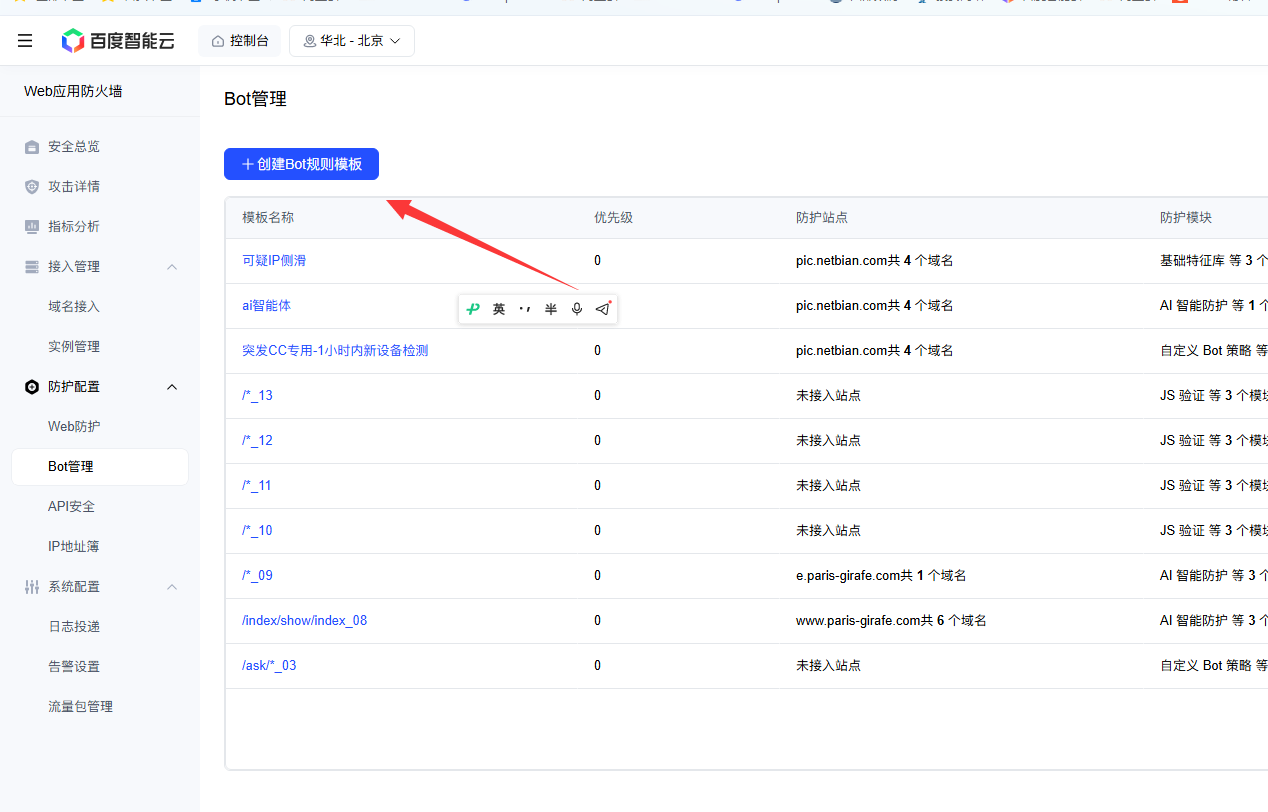

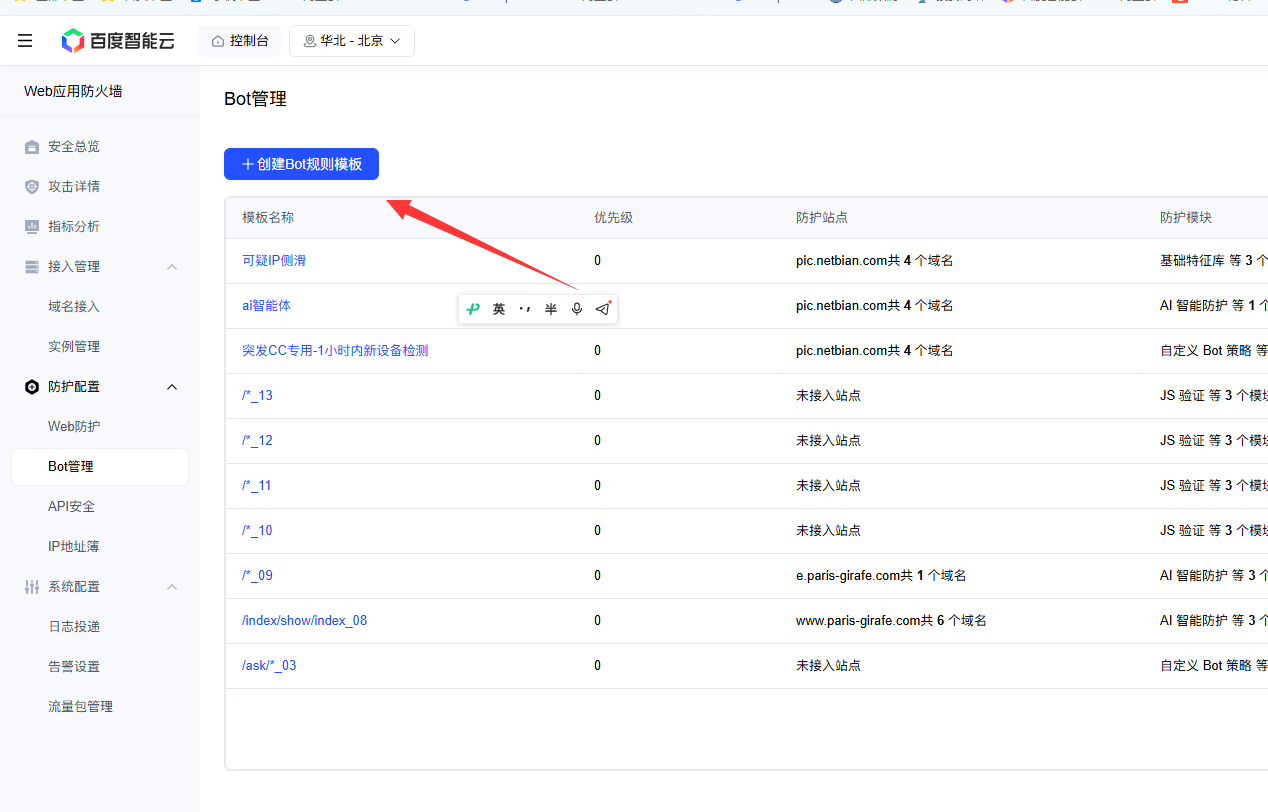
爬虫是站长们最头疼的问题之一:轻则疯狂采集内容、偷走搜索引擎排名,重则发起 CC 攻击拖垮服务器、撞库薅羊毛。近日,百度云防护 Web 应用防火墙(WAF)的 Bot 管理功能迎来一轮重要更新:在原有 JS 验证、动态令牌挑战等人机校验手段之上,新增 AI 智能防护、客户端画像分析、特征库识别、风险识别等多种识别能力,配合亿级规模的 IP 情报特征库,可以对各类 Bot 爬虫做「精准识别 + 分级处置」,而不是简单的一刀切封锁。
本文基于控制台实测截图,带大家过一遍新版 Bot 管理的完整能力。
一、为什么 Bot 管理值得单独讲?
先说清楚 Bot 流量的两面性。搜索引擎的抓取蜘蛛是「好爬虫」,站长巴不得它天天来;但更多的 Bot 是冲着坏事来的:
- 内容采集:整站扒文,原创排名被采集站反超;
- CC 攻击:模拟正常访问高频请求动态页面,打垮源站;
- 撞库与薅羊毛:批量提交登录、注册、领券接口;
- 漏洞扫描:自动化工具探测后台路径、敏感文件。
传统 WAF 对付它们只有两招:UA 黑名单和频率限制。但现在爬虫都学会了伪装 UA、挂代理池、控制频率,粗放的手段要么拦不住,要么误伤搜索引擎和真实用户。这次百度云防护更新的思路,就是把 Bot 识别做成一套「多层识别 + 分级处置」体系。
二、三步建模板:防护场景定义
新版 Bot 管理采用「规则模板」模式,创建一个防护场景只需三步:防护场景定义 → 防护规则配置 → 生效域名。
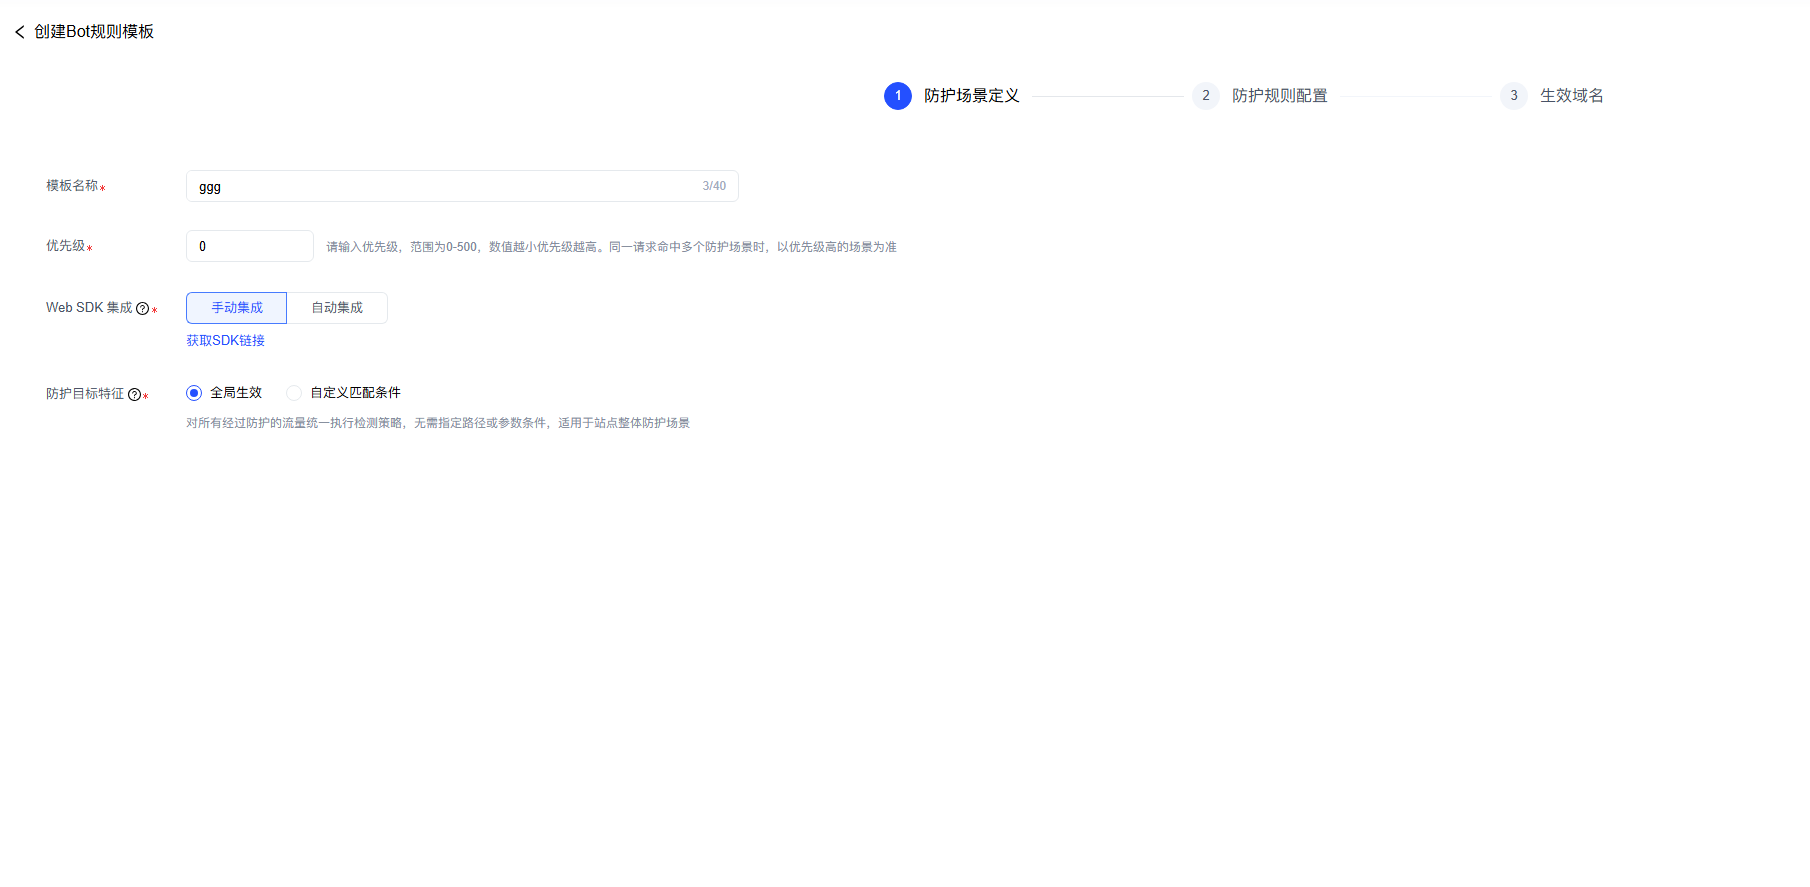
几个关键设计值得点赞:
- 优先级 0-500,数值越小优先级越高:同一请求命中多个防护场景时,以优先级最高的场景为准,多个模板之间不会打架;
- 防护目标特征支持「全局生效」和「自定义匹配条件」两种模式:整站防护用全局生效,只需对某个接口(比如登录、下单)重点防护的,走自定义条件,粒度到路径和参数级;
- Web SDK 集成支持手动/自动两种方式:SDK 采集客户端环境信息,是高级识别能力的数据基础。
三、四大防护模块:从协议校验到 AI 行为分析
第二步「防护规则配置」是本次更新的核心,Bot 识别能力分为四大模块:
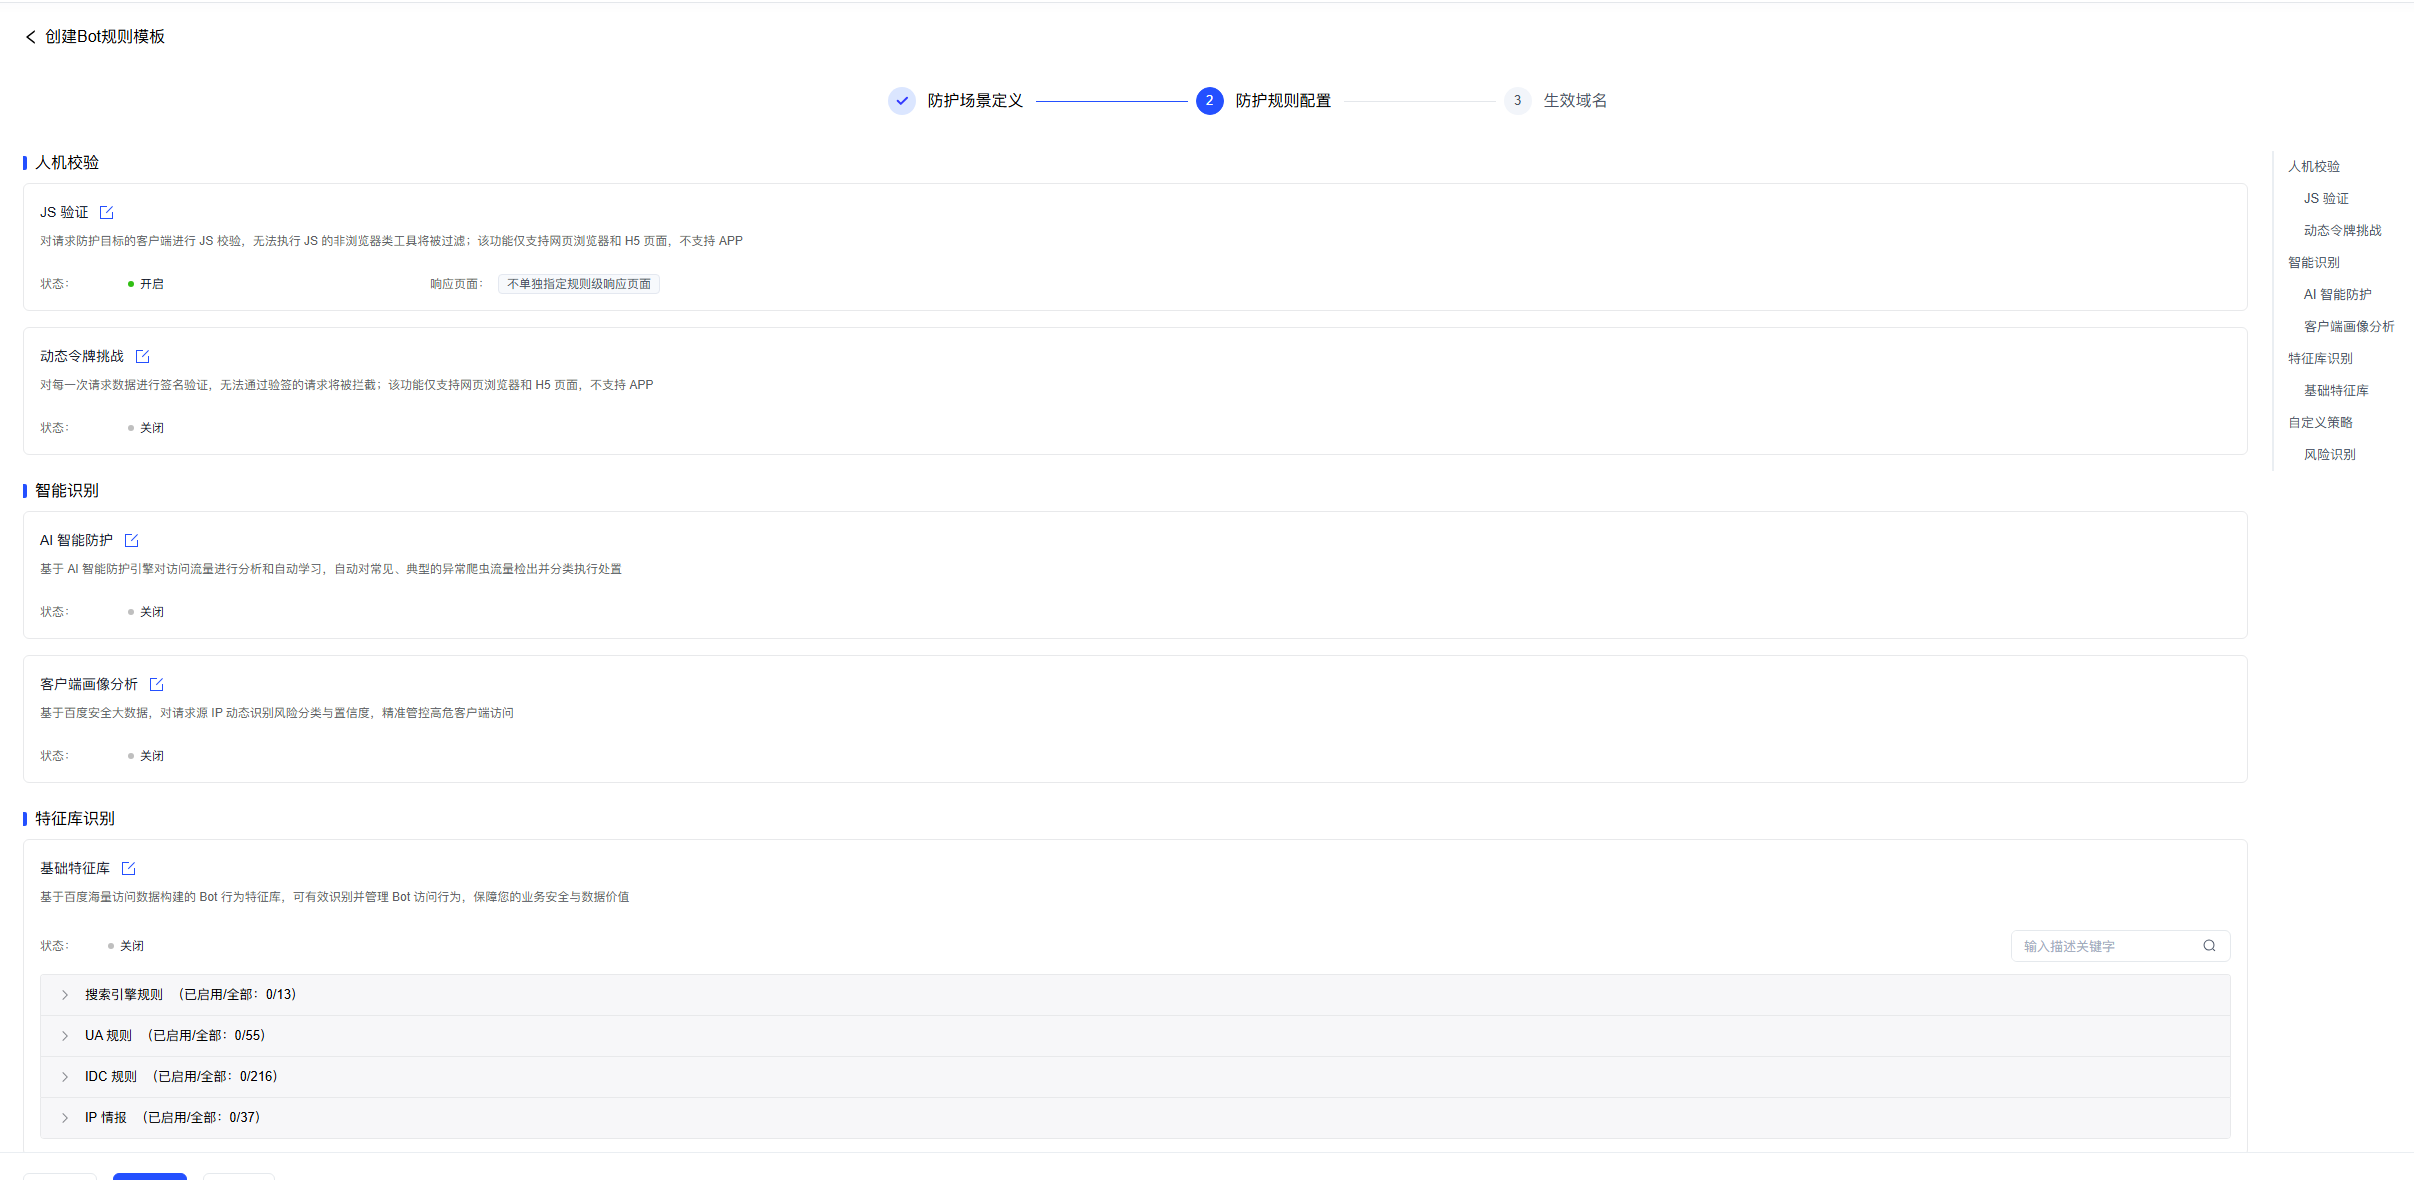
| 模块 | 能力 | 原理一句话 |
|---|---|---|
| 人机校验 | JS 验证 | 客户端执行 JS 校验,非浏览器工具直接过滤(仅支持网页/H5,不支持 APP) |
| 动态令牌挑战 | 每次请求签名验签,伪造请求直接拦截 | |
| 智能识别 | AI 智能防护 | AI 引擎对访问流量分析+自动学习,自动检出异常爬虫并分类处置 |
| 客户端画像分析 | 基于百度安全大数据,对请求源 IP 动态识别风险分类与置信度 | |
| 特征库识别 | 基础特征库 | 百度海量访问数据构建的 Bot 行为特征库(搜索引擎/UA/IDC/IP 情报) |
| 风险识别 | 账号风险标签 | 按账号维度(手机号等)匹配风险标签(如诈骗风险),精准拦截 |
这套体系的设计思路很清晰:人机校验拦「工具」、智能识别抓「行为」、特征库识「身份」、风险识别管「业务」,四层递进,各管一段。
四、AI 智能防护:恶意爬虫滑块验证,搜索引擎放行
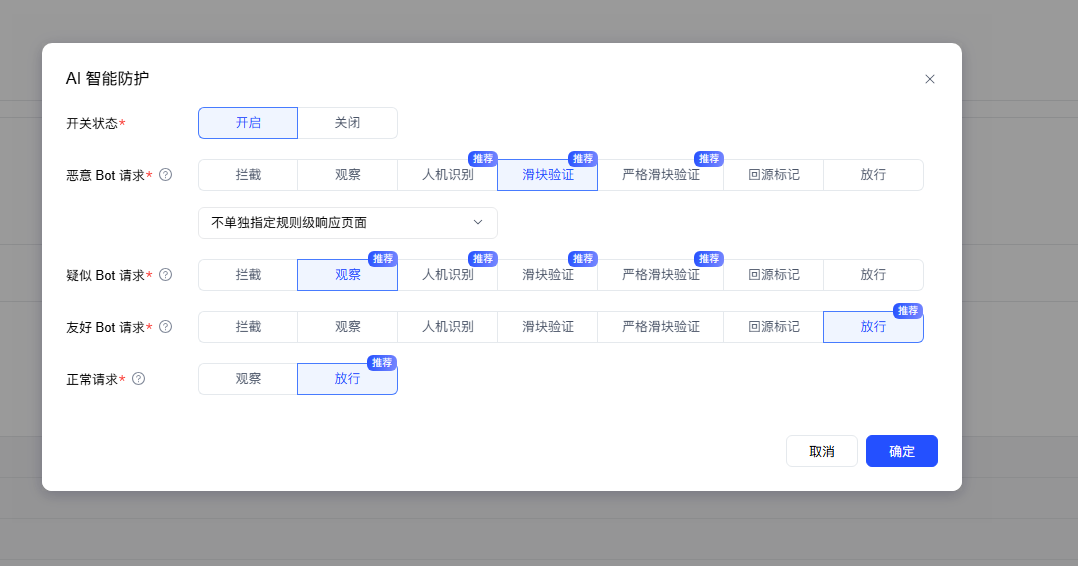
AI 智能防护是本次更新最大的亮点。开启后,AI 引擎会对访问流量自动分析和学习,把请求分成四类,每一类都有官方推荐处置动作:
| 请求分类 | 官方推荐 | 实际意义 |
|---|---|---|
| 恶意 Bot 请求 | 滑块验证 | 给一次人机验证机会,确认是真人再放行,误杀率低 |
| 疑似 Bot 请求 | 观察 | 拿不准先放行观察,积累行为数据再收紧 |
| 友好 Bot 请求 | 放行 | 搜索引擎蜘蛛等正常放行,SEO 排名不受影响 |
| 正常请求 | 放行 | 真实用户零感知 |
每类请求可选 7 种处置动作:拦截、观察、人机识别、滑块验证、严格滑块验证、回源标记、放行。这个颗粒度非常实用——比如对恶意 Bot 用「滑块验证」而不是直接「拦截」,既挡住了机器采集,又给可能的真人留了通道;对确认的攻击再上「拦截」,安全与体验兼顾。
五、客户端画像分析:风险 × 置信度双维管控
客户端画像分析的本质,是给每个来源 IP 打标签:基于百度安全大数据,动态识别请求源的风险分类与置信度,再按矩阵精细化处置。
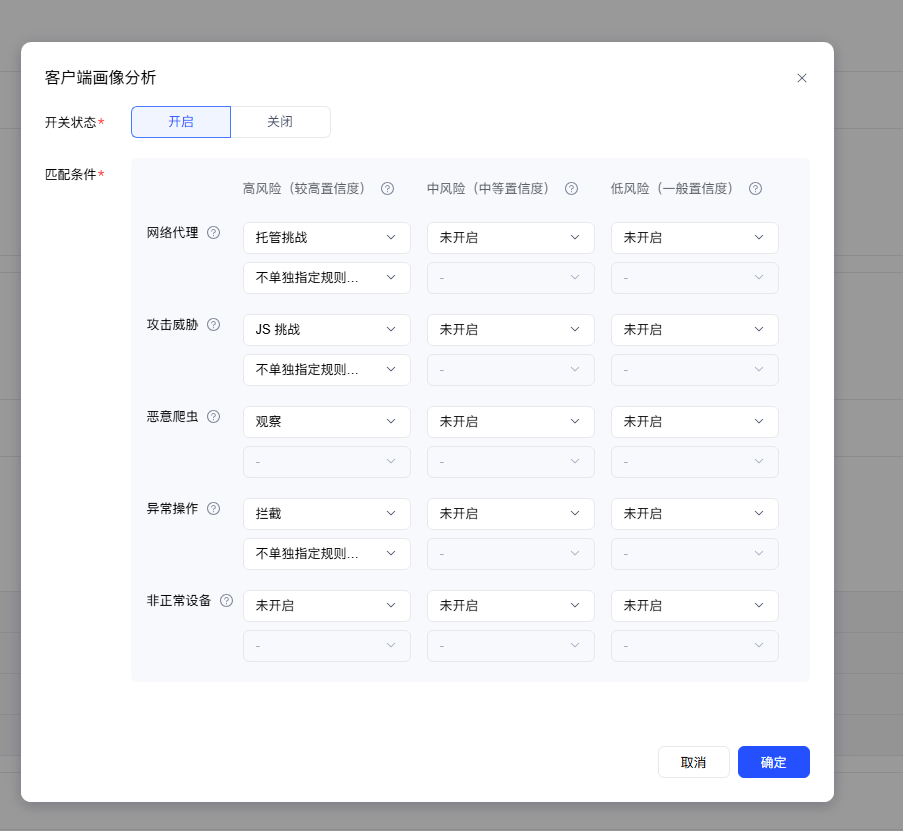
它把请求源风险分成 5 类——网络代理、攻击威胁、恶意爬虫、异常操作、非正常设备,每类再按置信度分高、中、低三档。截图里的配置思路就很典型:
- 高风险的网络代理 → 托管挑战(代理池是爬虫标配,直接挑战);
- 高风险的攻击威胁 → JS 挑战;
- 高风险的恶意爬虫 → 观察(先看两天再收紧);
- 高风险的异常操作 → 拦截(明显异常,直接掐断)。
中低置信度默认不处置,避免误伤——这种「按确定性分档出手」的设计,比一刀切靠谱得多。
六、特征库识别:55 条 UA 规则、216 条 IDC 规则、9000 万级 IP 情报
特征库识别是「经验层」的护城河,基于百度海量访问数据构建,分四个子库:
1. UA 规则(55 条):覆盖常见 Bot 的 User-Agent 特征,且处置动作可以按业务微调:
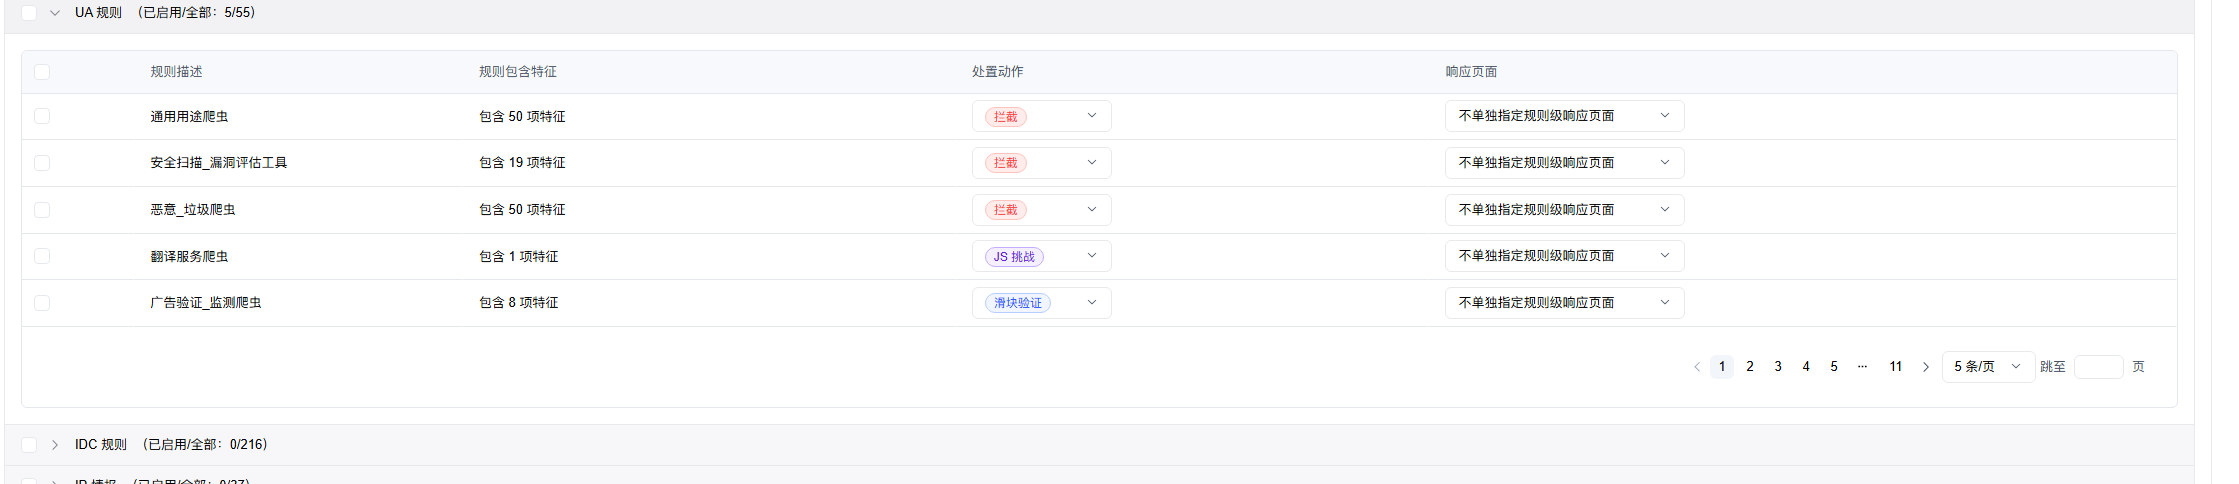
注意截图里的细节:通用途径爬虫、恶意垃圾爬虫直接拦截,翻译服务爬虫只给 JS 挑战,广告验证爬虫用滑块验证——同一类 Bot,不同用途,处置完全不同。翻译爬虫全拦了,海外用户就翻译不了你的页面;广告验证爬虫拦了,广告联盟可能判你违规。这种细粒度正是老牌安全厂商数据积累的体现。
2. IDC 规则(216 条):识别亚马逊、微软、谷歌、阿里云、中国电信等云厂商/IDC 的 IP 段。爬虫要规模化,基本都跑在云服务器上,真实用户极少从 IDC IP 正常访问:
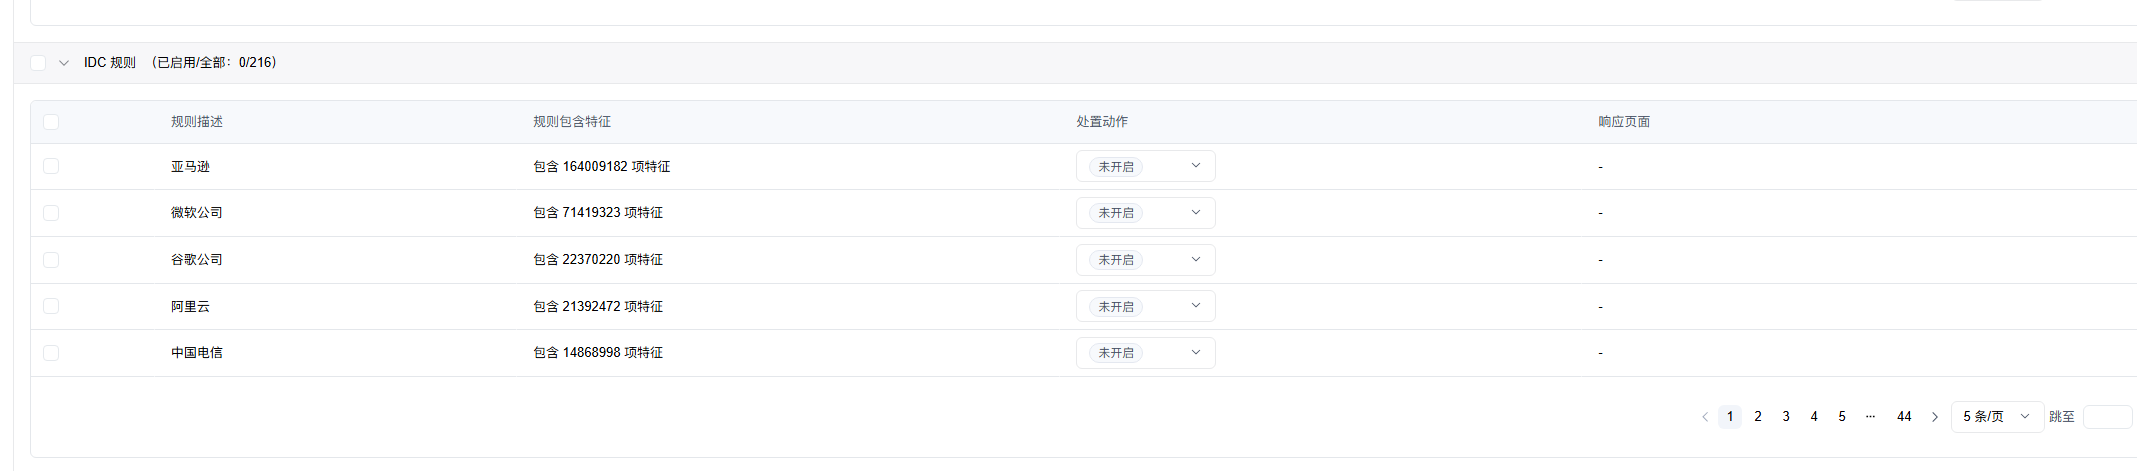
单亚马逊一家就有 1.64 亿项特征,微软 7100 万+、谷歌 2200 万+、阿里云 2100 万+,特征库规模是实打实的。
3. IP 情报(37 条):这是对抗「换壳爬虫」的大杀器:
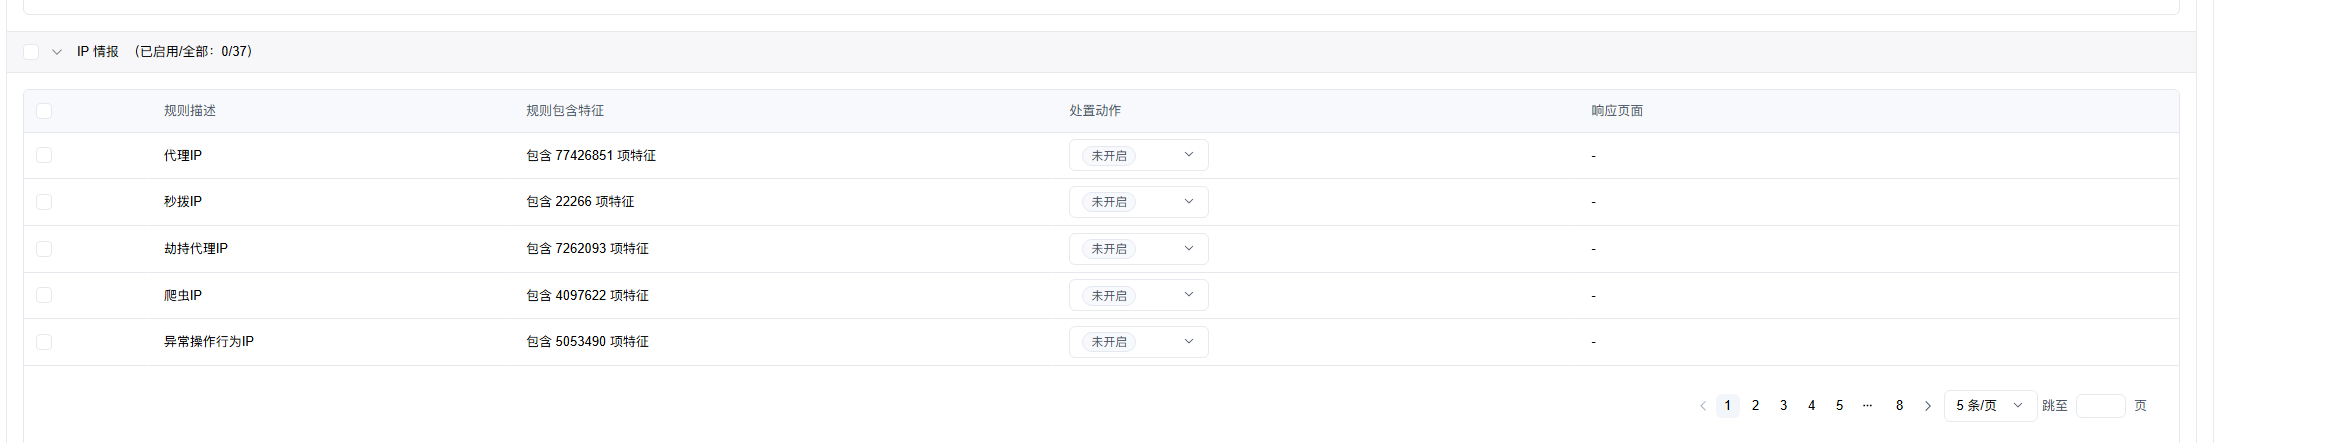
代理 IP 库 7742 万项特征、劫持代理 726 万项、爬虫 IP 409 万项、异常操作行为 IP 505 万项——爬虫就算伪装了 UA、控制了频率,只要它用的 IP 有「前科」,照样识别出来。秒拨 IP 库虽然只有 2.2 万项特征,但秒拨 IP 本身就是高风险的代名词,属于「命中即高危」的类型。
4. 搜索引擎规则(13 条):对百度、谷歌等正规搜索引擎蜘蛛做身份校验放行,保证 SEO 流量不被误杀——这对靠搜索吃饭的站长来说是最重要的一条。
七、风险识别:管到「账号」维度
前面模块都在管「IP 和流量」,风险识别则深入到了业务层:按账号维度做风险管控。
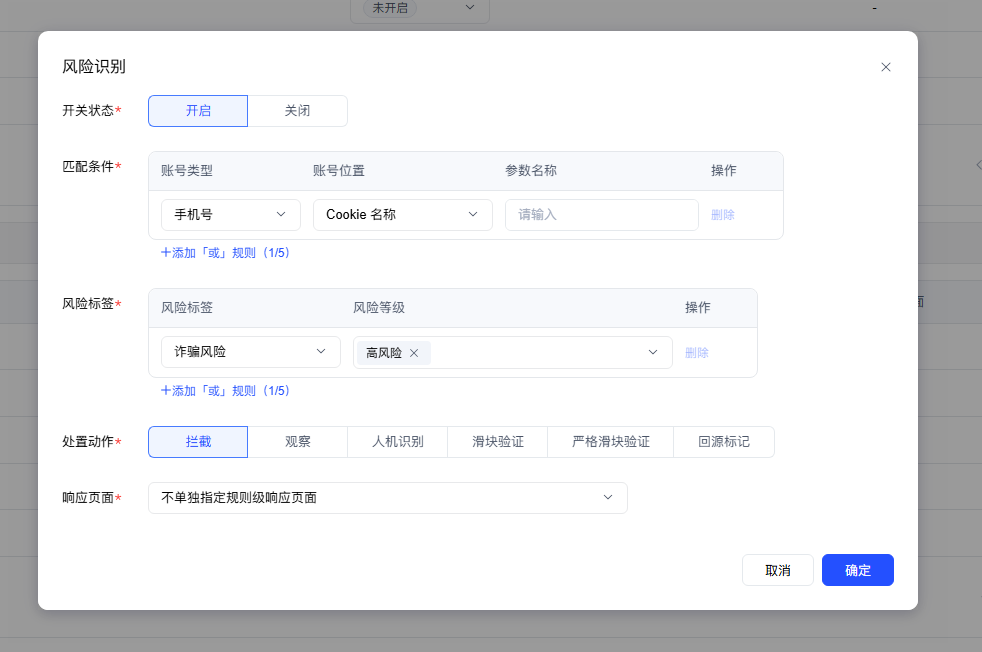
配置逻辑是「匹配条件 + 风险标签 + 处置动作」:比如识别到请求 Cookie 中携带的手机号命中「诈骗风险-高风险」标签,直接拦截;同样支持人机识别、滑块验证等柔性处置。对电商、金融、UGC 类站点,这套能力可以直接用于防薅羊毛、防欺诈场景。
八、站长配置建议
结合这次实测,给一套保守稳妥的上线路径:
- 先开「观察」跑一周:AI 智能防护的疑似 Bot、客户端画像的各中低风险项全部设为观察,只记录不处置,先摸清自己站点的 Bot 构成;
- 必开特征库拦截项:UA 规则里的通用爬虫、垃圾爬虫、漏洞扫描工具直接拦截,这批是公认的坏家伙,误伤概率极低;
- 搜索引擎规则务必放行:13 条搜索引擎规则保持启用,守护 SEO 基本盘;
- 再逐步收紧:观察数据显示误伤可控后,把恶意 Bot 升级为滑块验证或拦截,IDC/IP 情报按业务需要启用;
- 按路径精细化:登录、注册、下单等敏感接口单独建高优先级模板,配合风险识别做账号级管控。
Bot 对抗本质上是一场持久战:爬虫技术在升级(无头浏览器、AI 生成流量),识别能力也必须持续进化。这次百度云防护把 AI 行为分析、安全大数据画像、亿级特征库下放到云端 WAF 的 Bot 管理里,站长不用自己写反爬规则就能获得「识别 + 分级处置」的完整能力,对中小站点是很实在的福利。
如果你的站点正在被采集、CC 或者恶意扫描困扰,除了 Bot 管理,也可以了解速度网络高防 IP(包年包月,买多少峰值防多少,无后付费),配合百度云防护形成「应用层精准识别 + 网络层大流量兜底」的完整防护链。