
做过反爬的人大概都经历过这个循环:上 WAF、封 IP、加频率限制,头几天很有效;一周后对方换了 IP 池、伪造了 UA、把请求间隔拉到人类水平,你的规则全部失效。因为你在流量层做判断,而对方在解析层做工作。
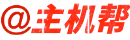
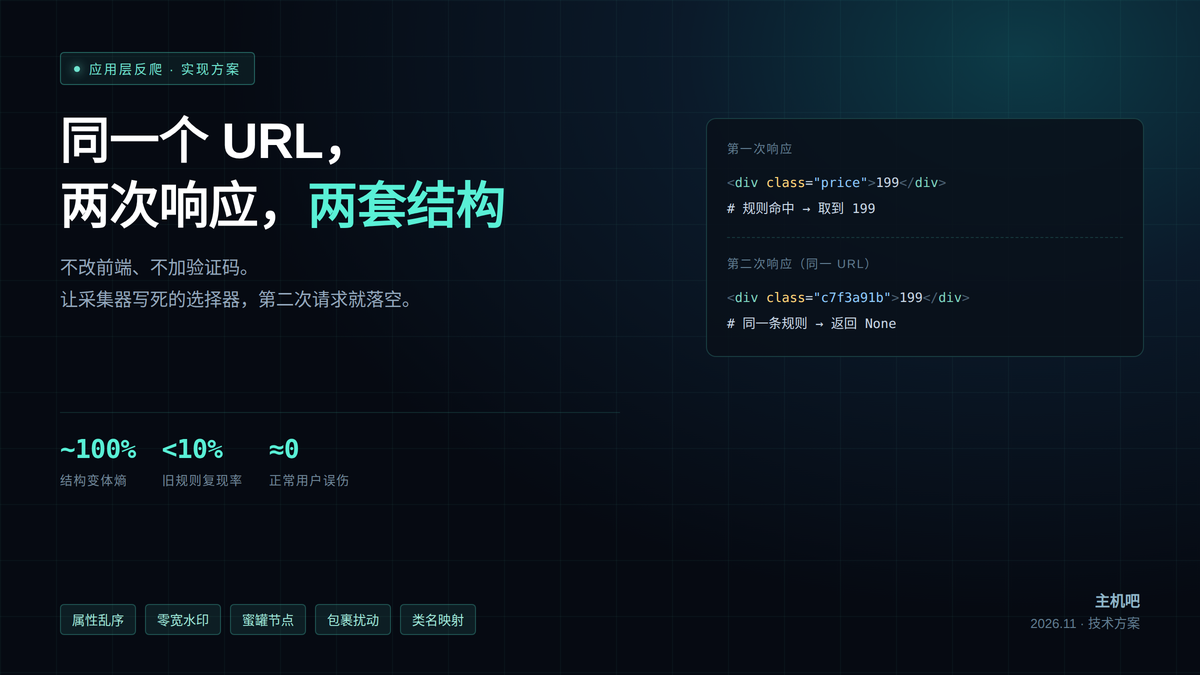
这篇文章讲的是一种在应用层做判断的思路——HTML 动态化:不改前端交互、不加验证码、不影响正常用户,只是让每次返回给同一个 URL 的 HTML 结构都不一样。采集器的选择器一旦写死,第二天就会全部落空。
它不替代 WAF,而是补上 WAF 够不着的那一段。
一、先搞清楚:流量层为什么拦不住「认真的爬虫」
把反爬拆成三层看,会清楚很多:
- 流量层:IP、UA、请求频率、JA3 指纹、ASN。WAF 和 CC 防护做的是这一段。
- 行为层:鼠标轨迹、滚动、点击、验证码、JS 挑战。人机识别做的是这一段。
- 解析层:对方用什么规则从 HTML 里取数据——这一层,几乎没人设防。
流量层的问题是可伪装:IP 池便宜、UA 是纯文本、频率可以降。行为层的成本高一些,但对抗也在升级——现在开源的无头浏览器方案连鼠标轨迹都能模拟。
而解析层不一样。一个采集器不管用 IP 池还是无头浏览器,最后都要做同一件事:从 HTML 里定位到那个价格、那个标题、那个电话。定位靠的是选择器,选择器依赖的是结构。结构一变,整条流水线就断了。
流量层决定「谁能进来」,解析层决定「进来之后能不能干活」。大多数站只做了前半句。
二、爬虫真正依赖的,是三份「稳定契约」
随手写一条采集规则你就明白了:
# 典型采集规则:价格在 class 为 price 的 div 里

price = response.xpath('//div[@class="price"]/text()').get()

# 更稳一点的写法:先定位列表,再取第 n 个

items = response.css('div.product-list > div.item')

for it in items:

    name  = it.css('h3.title::text').get()

    price = it.css('span.price::text').get()
这两条规则能跑通,靠的是三份契约同时成立:
- 类名契约:
class="price"这个名字是稳定的,写一次能用一年。 - 结构契约:
.product-list > .item > h3这个层级关系是稳定的,第几个子节点也是稳定的。 - 文本契约:
<span class="price">199</span>里的文字是完整的,一个节点装一个值。
HTML 动态化要做的,就是每次请求都让这三份契约失效。而且要在不破坏 CSS、不破坏 JS、不影响 SEO 的前提下做到。
三、五个可以组合的手法
手法不少,但关键是要分清哪些「不影响样式」、哪些「必须配套改造」。这张表是我自己在项目里用的取舍标准:
| 手法 | 破坏哪份契约 | 对 CSS 的影响 | 性能开销 | 建议 |
|---|---|---|---|---|
| 属性顺序随机化 | 正则式抓取 | 无 | 极低 | 必上,零风险 |
| 文本分片 + 零宽水印 | 文本契约 | 无 | 低 | 必上,还能溯源 |
| 诱饵节点(蜜罐) | 结构契约 | 无 | 极低 | 必上,可直接封禁 |
| 包裹层扰动 | 结构契约 | 轻微 | 低 | 推荐,注意 flex/grid |
| 类名映射 | 类名契约 | 有,需同步 | 中 | 看情况,收益最大也最危险 |
1. 属性顺序随机化
正常页面里 <a href="..." class="..." id="..."> 的属性顺序是固定的。有些采集器偷懒,直接用正则去抠 href="([^"]+)" class="([^"]+)"——顺序一乱,正则就匹配不上。
这个手法对浏览器完全透明,因为属性顺序本来就不影响渲染。成本几乎为零,收益是白捡的。
2. 文本分片 + 零宽水印
把一段文字拆成多个 <span>,或者在文本末尾插入不可见的零宽字符(U+200B / U+200C)。浏览器渲染出来一模一样,但采集器拿到的 ::text 里会多出一串乱码。
零宽水印更狠的地方在于可溯源:把访客标识编码成 0/1 序列写进正文。等你哪天在别处看到自己的内容被原样搬运,把那篇文章的文本复制出来跑一遍检测,就能确认它是从哪个会话流出的——虽然不能直接定位到人,但足以证明「这不是巧合」。
3. 诱饵节点(蜜罐)
在页面里塞几个正常用户看不见、但 DOM 里存在的链接:
<div style="position:absolute;left:-9999px;top:-9999px" aria-hidden="true">

  <a href="/?hd_bait=8f3a91c2" rel="nofollow">查看更多</a>

</div>
真人不会点,因为它在视口外;无头浏览器按 DOM 遍历时也「看得见」,但真正的采集器只取文本,不会访问链接。只要这个 URL 被请求了,几乎可以确定是自动化程序在遍历 DOM。服务端收到 hd_bait 参数,直接封 IP、记日志,比分析日志快得多。
这是我认为性价比最高的一招:实现成本三行 HTML,误伤率接近零。
4. 包裹层扰动
在内容外面随机插入 0–3 层无样式的 <div>,或者把同级节点的顺序打乱(仅限视觉上无先后要求的区块)。原来 .list > .item:nth-child(3) 能拿到第三条数据,现在拿到的可能是另一条,或者干脆是空。
要注意的是:flex / grid 布局下的子元素顺序会影响视觉,这类容器不能乱。安全的做法是只扰动那些 display:block 的包裹层。
5. 类名映射(收益最大,坑也最大)
把 class="price" 按盐值映射成 class="c7f3a91b",同一个类名在不同会话里长得完全不一样。采集器写死的 .price 直接失效。
但这里有个硬约束:CSS 也必须跟着变。外链样式表是静态文件,没法在后端改写,所以你只有两条路:
- 把
<style>内联进 HTML,一起做映射(页面变大,但可控); - 用构建期映射——每次发布换一套类名,而不是每次请求换(CSS 保持静态,采集器得重新分析,但撑不了太久)。
我的建议是:只对「数据节点」做映射(价格、库存、联系方式这类),布局类名不要动。这样内联的样式量很小,映射成本可控,也不会把整站 CSS 搞崩。
四、三层强度:别一上来就做最重的
「每次请求都变」听起来最爽,但缓存会先崩。分级实现更现实:
| 级别 | 变体粒度 | 缓存影响 | 实现成本 | 适合场景 |
|---|---|---|---|---|
| L1 构建期 | 每次发布换一次 | 无 | 低 | 内容站、更新不频繁 |
| L2 会话级 | 按 cookie 盐,同一访客稳定 | 按盐分片 | 中 | 大多数站点,推荐起点 |
| L3 请求级 | 每次响应都不同 | 基本不可缓存 | 高 | 高价值数据、API 型页面 |
L2 是甜点:同一个访客的页面结构保持一致(前端 JS、用户习惯都不受影响),但跨访客完全不同。采集器要适配,就得为每个新会话重新分析一遍结构,成本直接翻几十倍。
五、落地一:PHP 输出缓冲(改造成本最低)
适合 WordPress、Discuz 这类 PHP 站点,不用动 Nginx,加一个文件就能跑。
<?php

// 文件:/www/wwwroot/zhujib.com/inc/html-dynamic.php

// 引入:主题 functions.php 末尾 require_once get_template_directory().'/inc/html-dynamic.php';

define('HD_KEY', '换成一串随机32位字符');

function hd_salt(): string {

    $sid = $_COOKIE['hd_sid'] ?? '';

    if (!preg_match('/^[a-f0-9]{16}$/', $sid)) {

        $sid = bin2hex(random_bytes(8));

        setcookie('hd_sid', $sid, ['expires'=>time()+86400,'path'=>'/',

            'secure'=>true,'httponly'=>false,'samesite'=>'Lax']);

        $_COOKIE['hd_sid'] = $sid;

    }

    return $sid;

}

// 把一段文本的指纹编码成零宽字符:U+200B=0, U+200C=1

function hd_zero_width(string $text, string $salt): string {

    $hex = substr(hash_hmac('sha256', $text, HD_KEY.$salt), 0, 4); // 16 bit

    $out = '';

    foreach (str_split($hex) as $ch) {

        $b = hexdec($ch);

        for ($i = 3; $i >= 0; $i--) {

            $out .= (($b >> $i) & 1) ? "\u{200C}" : "\u{200B}";

        }

    }

    return $out;

}

ob_start(function (string $html): string {

    if (stripos($html, '<html') === false) return $html;      // 只处理整页

    if (hd_is_spider()) return $html;                           // 真蜘蛛放行

    $salt = hd_salt();

    // ① 段落文本尾部埋水印(只作用于 p 标签,避开 script/style)

    $html = preg_replace_callback(

        '#(<p\b[^>]*>)([^<]{20,})(</p>)#u',

        fn($m) => $m[1] . $m[2] . hd_zero_width($m[2], $salt) . $m[3],

        $html

    );

    // ② body 结束前插入蜜罐链接

    $bait = '<div style="position:absolute;left:-9999px" aria-hidden="true">'

          . '<a href="/?hd_bait=' . substr(hash_hmac('sha256','b',$salt),0,10) . '">更多</a></div>';

    return preg_replace('#</body>#i', $bait . '</body>', $html, 1);

});

// 蜘蛛判断:必须 UA + IP 双向校验,只认 UA 等于没校验

function hd_is_spider(): bool {

    $ua = $_SERVER['HTTP_USER_AGENT'] ?? '';

    if (!preg_match('/Baiduspider|Googlebot|bingbot/i', $ua)) return false;

    $ip = $_SERVER['REMOTE_ADDR'] ?? '';

    return in_array($ip, hd_allowed_spider_ips(), true);   // 自己维护的 IP 段清单

}蜜罐命中后的处理(放在主题最前面,早于任何页面渲染):
// 蜜罐命中:记日志 + 拉黑 24 小时

if (!empty($_GET['hd_bait'])) {

    $ip = $_SERVER['REMOTE_ADDR'] ?? '';

    error_log(sprintf('[HD_BAIT] %s %s %s', date('c'), $ip, $_SERVER['HTTP_USER_AGENT'] ?? '-'));

    // 宝塔 Nginx 黑名单文件,或直接写 iptables

    @file_put_contents('/www/server/panel/data/deny_ip.txt', $ip . "\n", FILE_APPEND);

    http_response_code(403);

    exit;

}
六、落地二:Nginx + OpenResty(性能最好)
如果站点有 CDN 或用了 OpenResty,在 Nginx 层做比 PHP 层更划算——静态页也能处理,而且不占 PHP 进程。
# /www/server/nginx/conf/lua/hd.lua

local function zw(tag)          -- 把 tag 的前 16bit 编成零宽字符

  local h = ngx.md5(tag)

  local out = {}

  for i = 1, 4 do

    local b = tonumber(h:sub(i, i), 16)

    for j = 3, 0, -1 do

      out[#out+1] = (math.floor(b / 2^j) % 2 == 1) and "\226\128\140" or "\226\128\139"

    end

  end

  return table.concat(out)

end

local _M = {}

function _M.body_filter()

  if ngx.ctx.hd_off then return end

  local chunk, eof = ngx.arg[1], ngx.arg[2]

  ngx.ctx.buf = (ngx.ctx.buf or "") .. (chunk or "")

  if not eof then return end                     -- 攒到整页再处理,避免标签被截断

  local html = ngx.ctx.buf

  ngx.ctx.buf = nil

  html = ngx.re.gsub(html, [[(<p[^>]*>)([^<]{20,})(</p>)]],

    function(m) return m[1] .. m[2] .. zw(m[2]) .. m[3] end, "jo")

  ngx.arg[1] = html

end

return _M
# 站点配置 server 块内(宝塔:网站 → 设置 → 配置文件)
location / {
rewrite_by_lua_block {
local ua = ngx.var.http_user_agent or ""
-- 蜘蛛、后台、API 一律跳过
if ua:find("Baiduspider") or ua:find("Googlebot")
or ngx.var.uri:find("^/wp%-admin") or ngx.var.uri:find("^/wp%-json") then
ngx.ctx.hd_off = true
end
}
body_filter_by_lua_file /www/server/nginx/conf/lua/hd.lua;
}注意两点:body_filter 是分块触发的,标签可能被切成两半,所以要攒到 eof 再统一处理;另外务必给处理加个页面大小上限(比如 > 512KB 就跳过),否则大页面会拖慢 worker。
七、落地三:边缘 Worker(不改服务器)
用 Cloudflare Workers 或任何支持的边缘函数平台,在响应回源之后改写 HTML。好处是源站一行代码都不用改,缺点是只有流量经过边缘时才有效。
const BAIT = '/?hd_bait=edge';
function zw(text) { // 简易指纹 → 零宽字符
let h = 0;
for (const c of text) h = (h * 31 + c.codePointAt(0)) & 0xffff;
let s = '';
for (let i = 15; i >= 0; i--) s += ((h >> i) & 1) ? '\u200c' : '\u200b';
return s;
}
export default {
async fetch(request) {
const res = await fetch(request);
const ct = res.headers.get('content-type') || '';
if (!ct.includes('text/html')) return res;
if (/Baiduspider|Googlebot/i.test(request.headers.get('user-agent') || '')) return res;
return new HTMLRewriter()
.on('p', {
text(t) { // 只在长文本尾部追加水印
if (t.text.trim().length > 20) t.after(zw(t.text), { html: false });
}
})
.on('body', {
element(el) {
el.append('
', { html: true });
}
})
.transform(res);
}
};
八、四个必须避开的坑
这套方案最容易被骂的地方不是技术难度,是它可能把正常业务搞坏。四个坑按严重程度排:
坑一:把蜘蛛也一起动态化了
搜索引擎抓到的是一份「结构每次都变」的页面,轻则重新分析、抓取预算浪费,重则判定为作弊。放行蜘蛛时必须做 UA + IP 段双校验——只认 UA 的白名单,攻击者一个 curl -A "Baiduspider" 就绕过去了,这种行为等于给全站开了免检通道。
坑二:缓存命中率崩塌
L2 会话级的变体意味着缓存要按 salt 分片,L3 请求级基本等于放弃页面缓存。做法是给 HTML 单独设策略:静态资源长缓存不动,HTML 走短缓存或干脆不缓存;CDN 侧对 HTML 关闭缓存,只做回源。
坑三:把 JS 依赖的 id 改掉了
只混淆 class,不要动 id——前端 JS 大量用 getElementById、querySelector('#xxx')、表单 label 的 for 关联。动了 id,页面交互直接崩。同理,name 属性(表单提交字段名)绝对不能改。
坑四:无障碍与 SEO 细节
aria-* 属性、alt、语义化标签不要动。零宽字符别加在标题(h1–h6)和 meta 描述里——搜索引擎的标题提取对不可见字符很敏感,可能出现乱码标题。
九、效果怎么衡量
上之前先定指标,否则你不知道是变好了还是变坏了:
| 指标 | 怎么算 | 健康值 |
|---|---|---|
| 变体熵 | 同一 URL 连续 100 次响应的结构指纹去重率 | L2 应接近 100% |
| 蜜罐命中 | 每日 hd_bait 请求数 / 独立 IP |
能稳定抓到,说明有自动化在扫 |
| 采集复现率 | 用旧选择器跑一遍,成功率 | 应降到 10% 以下 |
| 误伤率 | 正常用户投诉 / 页面 JS 报错数 | 接近 0,超过 0.5% 就要回滚 |
| 收录量 | 百度搜索资源平台的索引量曲线 | 上下浮动 10% 内可接受 |
| 首字节时间 | TTFB 前后对比 | 增幅 < 30ms |
其中「采集复现率」是最直接的验收指标:拿你自己之前写的采集脚本(或者网上现成的规则)跑一遍,成功率掉到 10% 以下,说明这套东西真的生效了。
十、它挡不住什么,以及和 WAF 怎么配合
说实话:它挡不住真正愿意投成本的对手。用 Puppeteer 打开真实浏览器、等 JS 渲染完再取文本,HTML 怎么变都不影响它——它取的是渲染结果,不是源码。
但这笔账要这么算:
- 原来对方改一行选择器就能继续跑;
- 现在他要么上无头浏览器(单请求成本从毫秒级涨到秒级,IP 消耗翻十倍),要么为每个会话重新分析结构(写一套适配流水线)。
反爬的本质不是「挡住」,是「让对方的单位成本高于收益」。动态化做的就是这件事——把它从「脚本小子」的门槛,抬到「需要工程团队」的门槛。
至于流量层的活,还是交给 WAF。像百度云防护的 Bot 管理能做客户端画像和风险识别,AI 爬虫分三档的思路能把训练类、索引类、代取类分开处理,这些是应用层做不到的——它看不到 JA3,也看不到 IP 信誉。
两层配合的分工很清楚:
| 层 | 管什么 | 典型手段 | 误伤成本 |
|---|---|---|---|
| 流量层(WAF / 云防护) | 频次、来源、指纹、CC | IP 黑名单、CC 策略、Bot 规则、区域封禁 | 中,配错会拦真人 |
| 解析层(HTML 动态化) | 结构、文本、DOM 行为 | 类名映射、水印、蜜罐、包裹扰动 | 低,正常用户无感 |
如果站点已经在用百度云防护,建议的顺序是:先用 WAF 把明显的机器流量挡掉(省带宽),再对剩下的「像人」的流量上动态化(省数据)。反过来做也行,但会多花不少清洗成本。
十一、写在最后
这套方法的门槛不在代码,在克制。
克制在于:只动该动的地方。id 不动、name 不动、布局类名不动、蜘蛛放行、后台放行、API 放行。能让采集器难受的手段有很多,但能让正常用户毫无感知的,往往只有那么几招——属性乱序、零宽水印、蜜罐链接,这三样几乎零风险,先把它们上齐,再考虑要不要碰类名映射。
反爬这件事没有终点。对方加一层渲染,你就加一层行为检测;他上代理池,你就做指纹聚类。能做的,是让每一步对抗的成本都比对手高一点。动态化是其中性价比很高的一步,因为它改的是结构,不是规则——规则会被研究,结构变化只能被重新适配。
本文代码为示意实现,上线前请在自己的测试环境验证;涉及改写 HTML 的操作,务必先在灰度域名跑一周再全量。