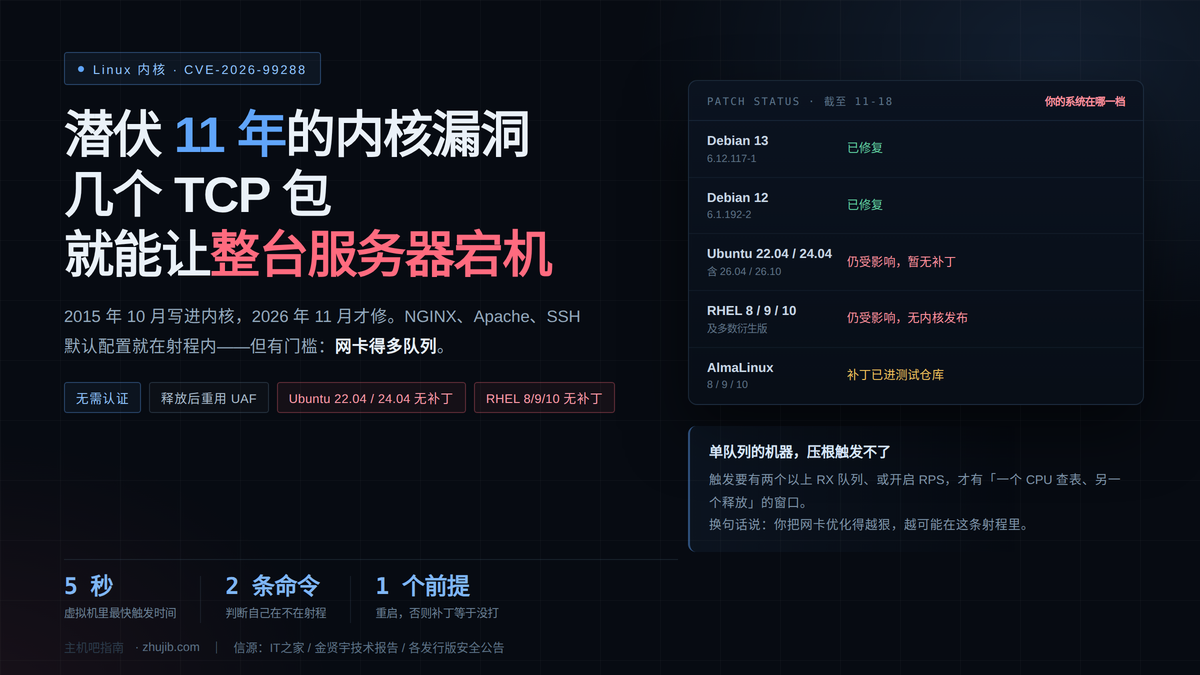

11 月 18 日消息,韩国安全研究员金贤宇(Hyunwoo Kim)披露了一个 Linux 内核高危漏洞,命名为 NoisyTCP,编号 CVE-2026-99288。攻击者不需要任何身份验证,只要向目标服务器发一串特制的 TCP 数据包,就可能让内核崩溃、整台服务器宕机。
更值得注意的是它的年龄:相关代码最早于 2015 年 10 月 3 日进入 Linux 内核,直到 2026 年 11 月 3 日才有修复提交进入上游。整整 11 年。
而对国内运维来说,最该关心的不是「11 年」这个数字,而是另一件事:这个补丁,你手上的系统现在大概率还装不上。Debian 已经修了,但 Ubuntu 22.04、24.04 和 RHEL 8、9、10 全系仍被标记为受影响。
一、这个漏洞干了什么:查表的时候,对象被换掉了
要理解 NoisyTCP,得先知道内核怎么处理 TCP 连接。
内核维护着一张「已建立连接」的哈希表,每来一个数据包,都要按四元组(源 IP、源端口、目的 IP、目的端口)去查这张表,找到对应的连接对象(socket)。为了性能,这个查询是无锁的——不加锁才能快,这是内核网络栈一直以来的设计取向。
问题就出在「无锁」上。当内核正在查表的时候,某个连接可能刚好被关闭并释放,而它占用的内存地址马上又被一个新的 socket 重新申请走了。
如果这个新对象恰好复用了相同的内存地址,并且还带着相同的连接信息,内核就会把新对象当成老对象,一头撞进去。金贤宇给出的其中一条利用路径是:诱使内核访问一个没有关联监听器的请求 socket,最终触发空指针解引用,内核直接崩溃。
这套链路在安全领域有个标准名字:释放后重用(Use-After-Free),简称 UAF。它是内核漏洞里最常见也最难查的一类——因为它依赖时序,不是每次都能复现。
二、「潜伏 11 年」这件事,本身值得琢磨
11 年没被发现,听起来像是「大家都没在查」。但真实原因更技术一些,也更值得记下来。
这个漏洞有明确的触发前提:目标服务器至少要有两个接收(RX)队列,或者启用了 RPS(接收数据包引导),让数据包能分散到多个 CPU 上并行处理——只有并行,才存在「一个 CPU 正在查表、另一个 CPU 同时在释放对象」的时间窗口。
换句话说,单队列的服务器根本触发不了。
而 2015 年是什么情况?那时候大量服务器还是千兆网卡、单队列,多队列是高端配置。真正让多队列变成标配的,是后来万兆网卡的普及、云主机的虚拟化网卡、以及容器平台对网络吞吐的要求。
所以有一个大概能解释「11 年」的说法:这个 bug 在 2015 年被写进去时,多数机器还不具备触发它的硬件条件;等硬件跟上来了,它才真正「活」过来。漏洞的年龄,不等于可利用的年龄。
需要说明,这是根据触发条件的推断,研究员本人没有这样表述。但它符合一个常见规律:很多潜伏多年的内核漏洞,不是当年没被扫到,而是当年的部署环境压根碰不到。
另一个佐证是触发时间。金贤宇的测试结果差异极大:
| 测试环境 | 触发耗时 | 说明 |
|---|---|---|
| QEMU / KVM 虚拟机 | 约 5 秒 ~ 2 分钟 | NGINX、Apache、SSH 默认配置即可触发 |
| 8 个 RX 队列的物理服务器 | 约 14 小时 | 负载较低,且需针对该环境调整时序 |
十四小时这个数字说明一件事:它不是一个能被「批量扫一遍全网」的漏洞。攻击者要打你,得先摸清你的队列配置,再调整发包时序,然后持续打上几个小时。这个成本决定了它更适合定向攻击——盯住某一个站,慢慢磨。
顺便说清楚边界:目前研究员只验证了远程拒绝服务。没有权限提升,没有远程代码执行,也没有证据表明能直接导致数据泄露。这决定了你该用多大的紧迫感来处理——不用连夜割接,但也不能拖到明年。
三、你的服务器在不在射程内:两条命令
判断标准很干脆:内核有没有修 + 网卡是不是多队列。两个都占,才需要紧张。
① 查实际运行的内核版本
# 当前实际运行的内核(升级后也必须看这个,不是看装了什么)

uname -r


# 系统里已安装的内核(看 /boot 下有几个 vmlinuz)

ls -1 /boot/vmlinuz-*


# 已安装的内核包,与发行版公告里的版本号对照

dpkg -l | grep linux-image      # Debian / Ubuntu

rpm -qa | grep ^kernel          # RHEL / CentOS / AlmaLinux
这里有个非常经典的坑:很多人 apt upgrade 完就以为搞定了,其实新内核装上了,但没重启,机器跑的还是老的。uname -r 才是真相,dpkg -l 只是「装了」。升级完内核必须重启,否则补丁等于没打。
② 查网卡接收队列和 RPS
# 先确认网卡名(一般叫 eth0 / ens33 / enp0s3 之类)

ip -br link


# RX 队列数量:大于 1 就满足了漏洞的第一个条件

ls -d /sys/class/net/eth0/queues/rx-* | wc -l


# 也可以问 ethtool,看 Combined 那一行

ethtool -l eth0


# RPS 是否开启:输出里有非 0 值,说明开了

for f in /sys/class/net/eth0/queues/rx-*/rps_cpus; do echo "$f = $(cat $f)"; done
顺带把发行版也确认一下,后面查补丁要用:
cat /etc/os-release | grep -E 'PRETTY_NAME|VERSION_ID'如果队列数是 1、RPS 也全是 0,那这个漏洞在你机器上没有触发窗口,可以先按常规节奏走。如果队列数是 8、16 甚至更多,那你就在射程内——而且这多半是你当初为了压榨吞吐量主动开的,属于「优化带来的副作用」。
四、修复进度:一张表看清你的系统有没有补丁
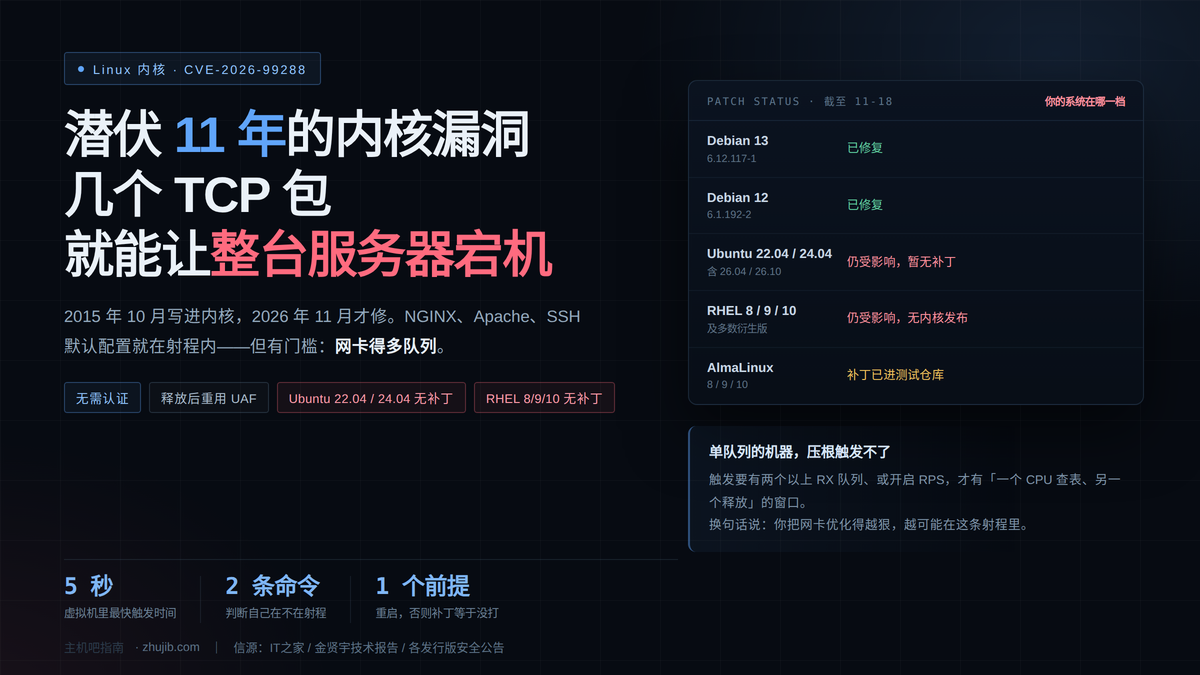
这是全文最该被截图保存的部分。同样一个漏洞,不同发行版的节奏差出好几周:
| 发行版 / 分支 | 状态 | 修复版本 |
|---|---|---|
| Debian 13 | 已修复 | 6.12.117-1 |
| Debian 12 | 已修复 | 6.1.192-2 |
| Ubuntu 22.04 / 24.04 / 26.04 / 26.10 | 仍标记为受影响 | 暂无 |
| RHEL 8 / 9 / 10 | 仍标记为受影响 | 尚无修复内核发布 |
| AlmaLinux 8 / 9 / 10 | 已回移植补丁 | 进入测试仓库 |
上游的修复版本是 Linux Kernel 6.12.117、6.18.63、7.4.4,主线开发版已进入 7.4-rc2。
这里有个容易看错的地方,值得单独提醒:内核官网在 11 月 17 日显示的「最新版本」是 6.12.118、6.18.64、7.3.5。注意 7.3.5 的版本号比修复版 7.4.4 还小——也就是说,「装最新版」不等于「装到修复版」,分支不一样。别看版本号大小做判断,直接查发行版的安全公告。
对国内读者来说,这张表有两个不太好的消息:
一是 Ubuntu 22.04 和 24.04 都在「受影响」里。这两个版本是国内云主机装机量最大的系统之一,而且 24.04 还是当前的 LTS 主力。也就是说,相当一部分读者的机器,现在没有官方补丁可打。
二是 RHEL 8/9/10 全系都没有。衍生版里 AlmaLinux 已经把补丁回移植进测试仓库了,说明技术上不难,只是 RHEL 的流程还没走完。如果你用的是 Rocky Linux 或国内的各种 RHEL 系衍生版,值得盯一下自己上游的进度。
五、打上补丁之前:缓解方案,以及它的代价
金贤宇在 GitHub 上给了两套临时缓解思路,都是掐掉触发条件,不是修漏洞。
方案 A:关闭 SYN Cookies
# 临时关闭(立即生效)

sysctl -w net.ipv4.tcp_syncookies=0


# 确认当前值

sysctl net.ipv4.tcp_syncookies


# 如果要持久化(注意:这是有代价的,见下文)

echo 'net.ipv4.tcp_syncookies = 0' >> /etc/sysctl.conf
这个方案的代价必须说清楚:关闭 SYN Cookies 会削弱服务器抵御 SYN Flood 的能力。SYN Cookies 本来就是为抗 SYN Flood 设计的,关掉它等于拆掉一层 DDoS 防护——用一个攻击面换另一个攻击面。
所以在做这个决定前,先问自己三个问题:你的站有没有被 SYN Flood 打过?有没有前置的高防或 CDN?如果两个答案都是「有」,关掉可能划算;如果服务器直接裸露在公网、也没有任何前置防护,关掉之后你换来的风险可能比 NoisyTCP 本身更大。
方案 B:把接收队列压到 1,并关闭 RPS / RFS
# 队列合并为 1(会降低多核网络吞吐,慎用)

ethtool -L eth0 combined 1


# 关闭每个接收队列的 RPS

for f in /sys/class/net/eth0/queues/rx-*/rps_cpus; do echo 0 > "$f"; done


# 关闭 RFS

sysctl -w net.core.rps_sock_flow_entries=0

for f in /sys/class/net/eth0/queues/rx-*/rps_flow_cnt; do echo 0 > "$f"; done


# 验证:队列数应为 1,rps_cpus 应全为 0

ls -d /sys/class/net/eth0/queues/rx-* | wc -l这套方案的代价是吞吐量。把 8 队列压成 1,等于放弃了多核并行收包——对高并发站点、大流量下载站、API 网关来说,这个损失是能直接感受到的。而且这些设置重启后会丢,需要写进开机脚本才有意义。
两套方案的取舍,简单说:
| 方案 | 掐掉的触发条件 | 代价 | 适合谁 |
|---|---|---|---|
| A. 关 SYN Cookies | 缩短连接建立阶段的时间窗口 | 抗 SYN Flood 能力下降 | 有前置高防 / CDN 的站 |
| B. 队列压到 1 + 关 RPS | 消灭多 CPU 并行,直接去掉竞态窗口 | 网络吞吐下降,重启失效 | 低流量站、内网服务 |
无论选哪个,都请记住一句:这是过渡,不是终点。它把风险从「随时可能被打」降成「暂时打不到」,但你仍然是未修复状态。
六、容器的放大效应:打一个站,整台机器跟着倒
这次有个细节对国内站长特别不友好,容易被忽略。
漏洞出在 Linux 内核网络栈,不在应用层。也就是说,如果你的站跑在 Docker 容器里,攻击者打的是容器,崩的却是宿主机内核——同一台机器上的其他容器、面板、数据库、备份任务,会一起倒。
这在国内很常见:一台 4 核 8G 的服务器上,用宝塔或 1Panel 跑着七八个站,每个站一个容器或者一个 PHP 池。平时觉得「隔离得挺好」,但内核崩溃这件事,容器隔离根本挡不住——它们共享同一个内核。
两个月前我们写过另一个内核漏洞 SCTPhantom,那个是 18 年历史、能逃逸容器控制宿主机。这次的 NoisyTCP 是 11 年历史、只能打宕机——杀伤力小一档,但触发门槛低得多:SCTPhantom 要 SCTP 协议,而 TCP 是每台服务器都在跑的。
所以判断逻辑要改一下:不要问「我这个站会不会被打」,要问「这台机器上有几个站,倒一个是不是全都倒」。如果答案是「全都倒」,那这个漏洞的实际影响就不是「一个站下线」,而是「一台服务器下线」。
七、写在最后
这件事有几个层面值得记下来。
第一,漏洞的年龄不等于威胁的年龄。2015 年写进去的代码,等到多队列成为标配才真正具备可触发性。所以看到「潜伏 N 年」这种描述,别只当作猎奇数字,它往往在提示一件事:这个漏洞的可利用性,和你现在的基础设施配置强相关。你的机器越「优化」过,越可能在射程内。
第二,补丁的可得性,比漏洞的严重性更影响你的决策。Ubuntu 22.04/24.04 和 RHEL 全系现在没补丁,这不是你努力就能解决的——它取决于发行版和上游的排期。在这种时候,临时缓解方案的价值就被放大了,哪怕它有代价。
第三,别把「已修复」理解成「已生效」。内核更新装完必须重启,uname -r 没变就是没生效。这条在别的漏洞上也许能拖,在需要重启才生效的内核补丁上,拖一天就是裸奔一天。
今天能做的:
先跑第三节那两条命令,确认队列数。队列是 1 的,把这件事记进日历就行;队列大于 1 的,去查发行版公告,看补丁到了没有。没到的,评估一下两套缓解方案的代价,选一个先顶上。补丁到了,安排重启窗口,装完 uname -r 核对一遍。
整件事里最不需要做的,是恐慌。远程拒绝服务、要打几个小时、还得先摸清你的配置——它不是一个能让全网服务器同时倒下的漏洞。但它确实是一个「值得这个月处理掉」的漏洞,这两件事不冲突。