
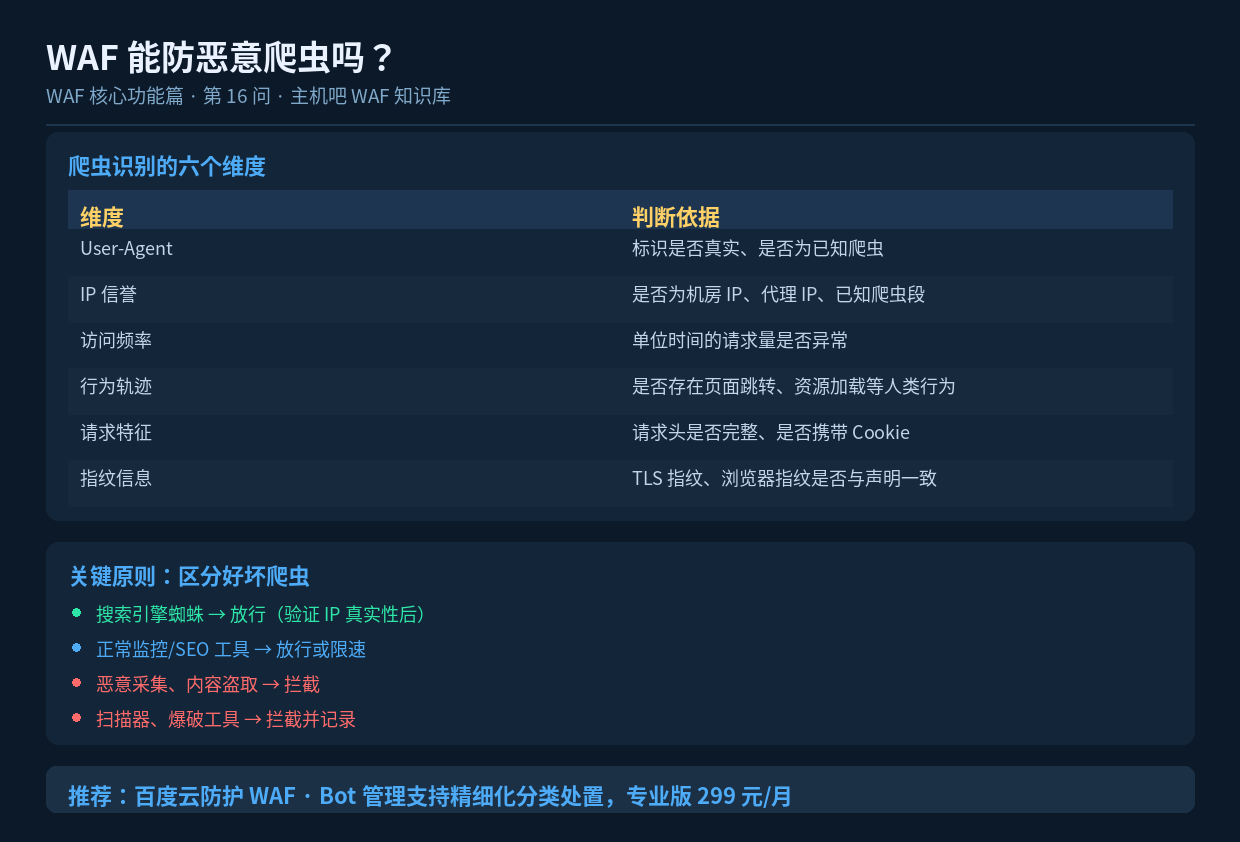

速读摘要:WAF能通过User-Agent、IP信誉、访问频率、行为轨迹、请求特征、指纹信息六个维度识别恶意爬虫。关键在于区分「好爬虫」与「坏爬虫」——搜索引擎蜘蛛应放行,恶意采集需拦截。本文讲清爬虫识别维度、误伤规避方法与配置建议。
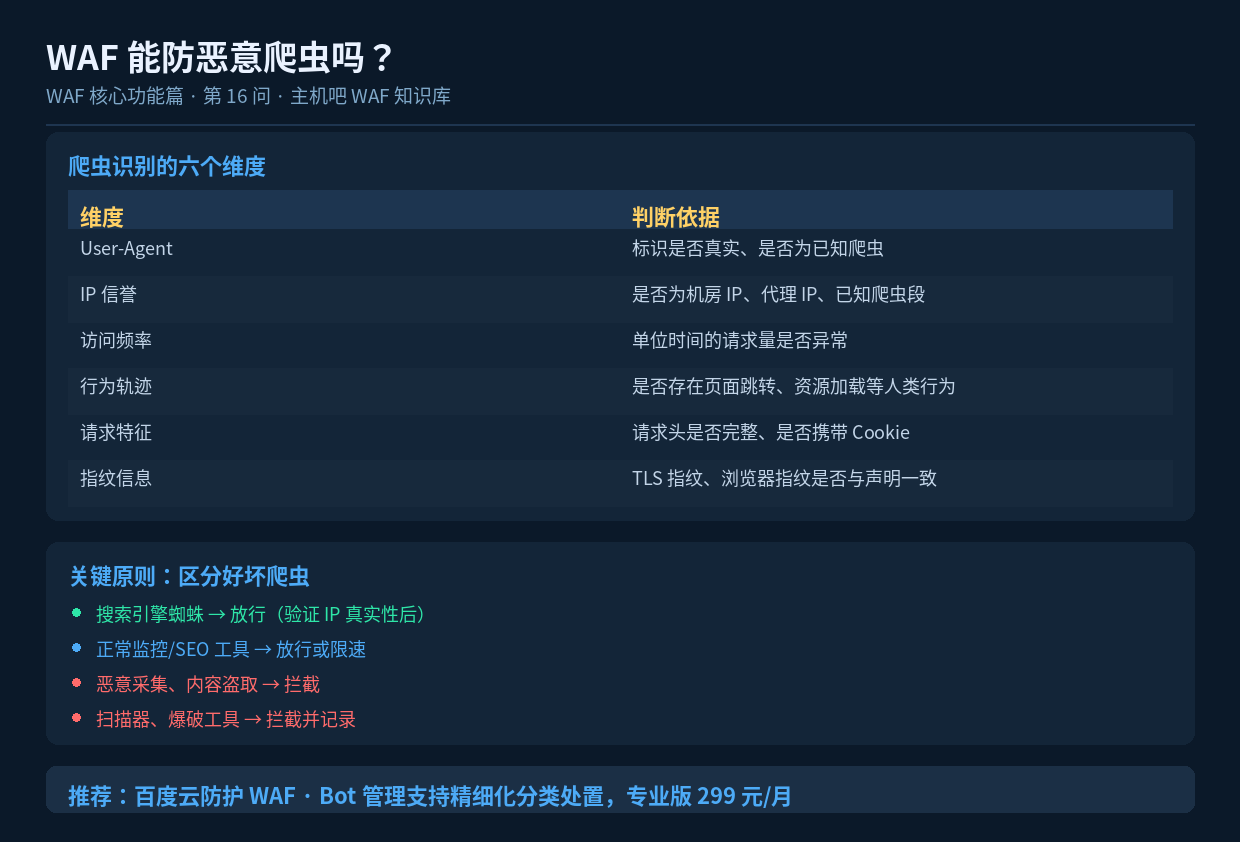
一、为什么爬虫防护要「区别对待」
爬虫防护最忌讳的做法是「一刀切」——把所有非浏览器请求全部拦掉。因为:
- 搜索引擎蜘蛛也是爬虫——拦了它们,你的内容就不会被收录;
- 很多正常服务也是爬虫——比如网站监控、SEO 分析工具、内容聚合服务;
- 误伤成本很高——一旦误封搜索引擎,流量损失会持续数周。
所以爬虫防护的核心不是「拦爬虫」,而是「区分好爬虫和坏爬虫」。这也是「Bot 管理」比单纯的「爬虫防护」更专业的地方。
二、识别爬虫的六个维度
1. User-Agent
最基础的判断依据,也是最容易被伪造的。WAF 通常维护一份 UA 库:
| UA 类型 | 特征 | 处置 |
|---|---|---|
| 主流搜索引擎 | Baiduspider、Googlebot 等 | 放行(需验证 IP) |
| 已知工具 UA | python-requests、curl、Scrapy 等 | 按需拦截或限速 |
| 空 UA | 没有 User-Agent 头 | 通常为脚本请求,可拦截 |
| 伪造 UA | 声称是浏览器但行为异常 | 结合其他维度判定 |
仅凭 UA 判断是不够的——攻击者可以轻松伪造 UA 冒充搜索引擎。所以需要配合 IP 验证。
2. IP 信誉
更可靠的判断依据:
- 搜索引擎的真实 IP 段——官方会公布,可验证 UA 是否名副其实;
- 数据中心/云机房 IP——正常用户很少从机房 IP 访问;
- 代理与 VPN IP 段——爬虫常用;
- 已知恶意 IP 库——威胁情报积累。
3. 访问频率
人类浏览有自然的停顿,而爬虫会以稳定、高速的节奏持续请求。但要注意:分布式爬虫会分散到大量 IP,单 IP 频率可能并不高。
4. 行为轨迹
这一维度最能区分「人」与「机器」:
| 行为 | 人类 | 爬虫 |
|---|---|---|
| 页面跳转 | 有明确路径(首页→栏目→详情) | 直接命中目标 URL |
| 资源加载 | 会加载图片、CSS、JS | 通常只取 HTML |
| 停留时间 | 有阅读停顿 | 几乎无间隔 |
| Referer | 通常携带来源页 | 常常为空或伪造 |
5. 请求特征
爬虫的请求头往往不完整或有不自然的组合:
- 缺少 Accept、Accept-Language 等常见头;
- 请求头的顺序与真实浏览器不符;
- 不携带或携带异常的 Cookie;
- HTTP 版本或连接方式异常。
6. 指纹信息
更高级的识别手段,针对加密流量场景:
- TLS 指纹(JA3/JA4)——不同客户端库的 TLS 握手特征不同,可以识别出「声称是 Chrome 但实际是 Python 脚本」;
- 浏览器指纹——通过 JS 采集屏幕分辨率、字体、Canvas 等特征,判断是否为真实浏览器。
三、处置手段
| 手段 | 适用场景 | 用户体验 |
|---|---|---|
| 限速 | 疑似爬虫但不确定 | 正常用户无感 |
| JS 挑战 | 需要验证是否为真实浏览器 | 首次访问略慢 |
| 滑块验证 | 高置信度恶意流量 | 需人工交互,会影响效率 |
| 返回假数据 | 对付内容采集 | 对真实用户无影响,爬虫拿到脏数据 |
| 直接封禁 | 明确的恶意源 | 无感,注意误封 |
特别提一下「返回假数据」这个思路——对付内容盗取网站特别有效。爬虫会拿到污染过的数据,而真实用户完全不受影响。
四、如何避免误伤搜索引擎
① 验证蜘蛛真实性
不要只看 UA。正规做法是:当 UA 声称是某搜索引擎蜘蛛时,反向解析其 IP,确认是否为官方 IP 段。假冒的蜘蛛会被识别出来。
② 给蜘蛛设白名单
把已验证的搜索引擎 IP 段加入白名单,确保不会被频率限制误伤。
③ 定期检查抓取情况
在搜索引擎站长平台查看抓取统计,如果发现抓取量异常下降,要排查是否被 WAF 误拦。
五、站长配置建议
- 先开启观察模式——记录爬虫访问情况,了解自己的站点被哪些爬虫访问、频率如何;
- 重点保护核心内容——对付费内容、独家数据做更严格的防护;
- 静态资源可放宽——图片、CSS 等资源被爬取影响较小,不必过度拦截;
- 关注带宽消耗——如果带宽被爬虫大量消耗,就需要针对性限制;
- 定期复盘日志——观察拦截效果,调整规则减少误伤。
六、小结
WAF 防爬虫的关键在于「精准分类」而非「全部拦截」。通过 UA、IP、频率、行为、请求特征、指纹六个维度综合判断,既能拦住恶意采集,又能放行搜索引擎。配置时牢记一条原则:宁可少拦,不可误伤搜索引擎——收录损失的代价远大于省下的带宽。
