
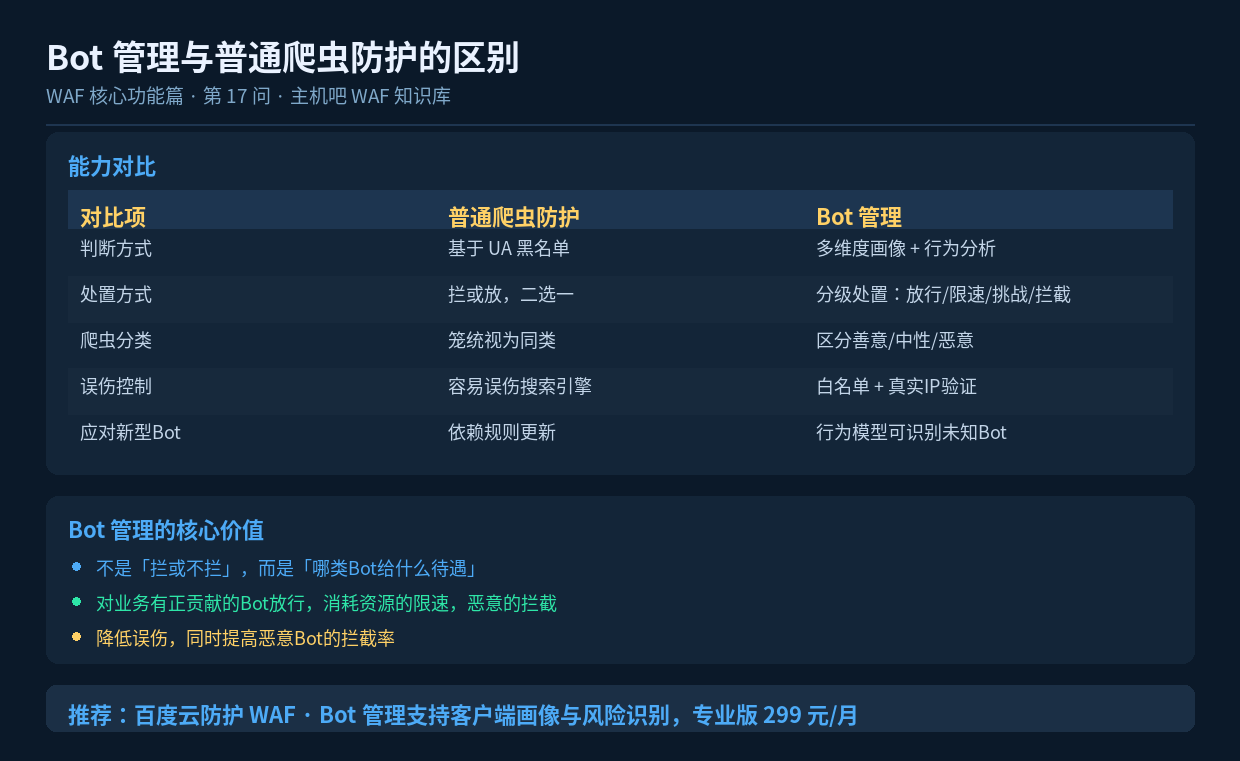

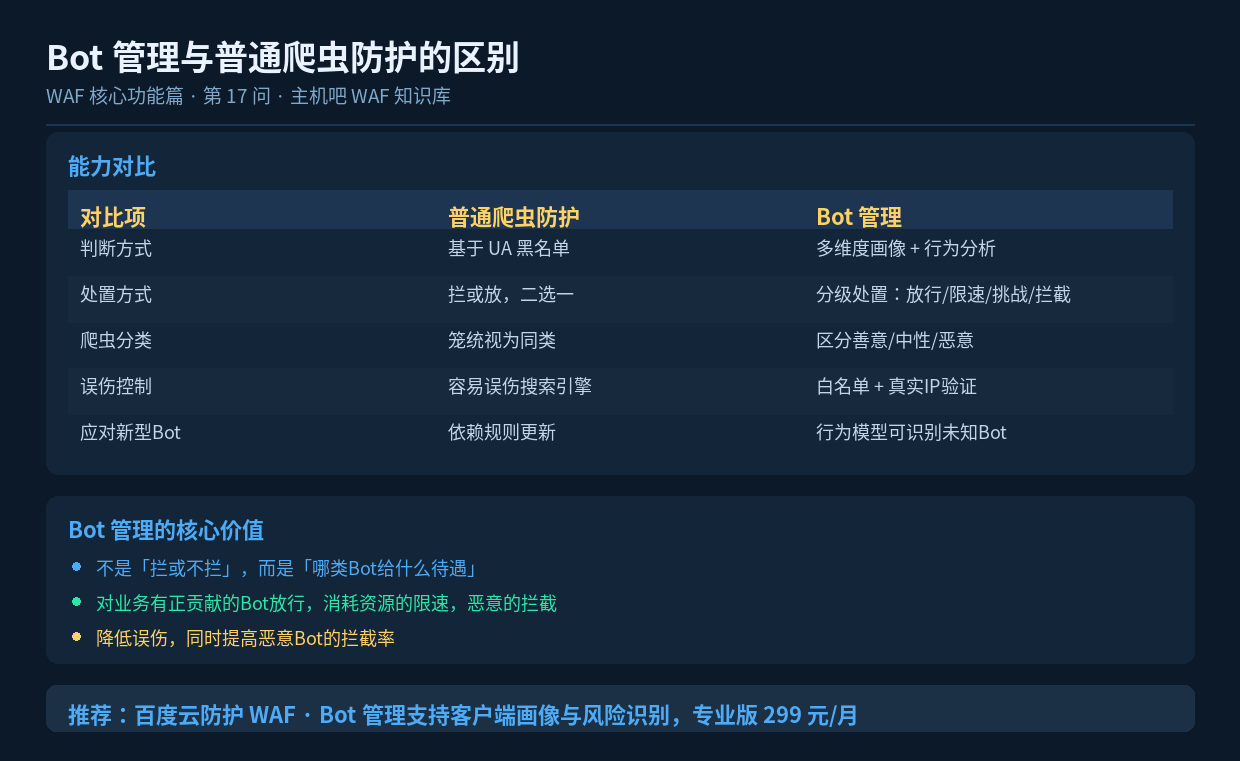
速读摘要:Bot管理与普通爬虫防护的核心区别在于「精细化程度」。传统爬虫防护基于UA黑名单,只有拦或放两种选择;Bot管理则通过多维度画像和行为分析,把Bot分为善意、中性、恶意三类,对应放行、限速、挑战、拦截四级处置。本文讲清两者差异与Bot管理的实际价值。
一、从「拦不拦」到「给什么待遇」
普通爬虫防护的思路很朴素:判断是不是爬虫,是就拦,不是就放。这是一个二元决策。
Bot 管理的思路则完全不同:先识别这是什么类型的 Bot,再决定给它什么待遇。这是一个多维度、多选项的决策。
为什么需要这种差异?因为流量世界里「机器访问」的比例远高于普通人的想象——有统计显示,互联网流量中相当大比例来自各种自动化程序。它们中:
- 有些是必须放行的——搜索引擎蜘蛛、网站可用性监控;
- 有些是可以协商的——SEO 分析工具、内容聚合服务,可以放行但限速;
- 有些必须拦截——恶意采集、账号爆破、扫描器。
用二元决策处理这三种情况,必然要么误伤、要么漏放。
二、能力对比
| 对比维度 | 普通爬虫防护 | Bot 管理 |
|---|---|---|
| 判断依据 | 主要为 User-Agent 黑名单 | UA + IP + 行为 + 指纹多维画像 |
| 处置方式 | 拦截 / 放行 | 放行 / 限速 / JS挑战 / 滑块 / 拦截 |
| 分类粒度 | 笼统归为「爬虫」 | 按善意、中性、恶意分级 |
| 误伤控制 | 较易误伤搜索引擎 | 真实 IP 验证 + 白名单 |
| 新型 Bot 应对 | 依赖规则库更新 | 行为模型可识别未知模式 |
| 可视化 | 简单的拦截计数 | Bot 流量占比、分类统计、趋势分析 |
三、Bot 管理的技术实现
1. 客户端画像
所谓「画像」,是指为每个访问者建立一份特征档案,综合多个信号判断其性质:
- 这个 IP 属于哪个网络(家宽、机房、代理);
- TLS 指纹对应的客户端库是什么;
- 请求头是否完整、是否符合声明的浏览器特征;
- 历史行为记录(是否曾被标记为恶意)。
2. 行为分析
通过一段时间内的访问模式判断:
- 访问路径是否符合人类浏览习惯;
- 请求间隔是否过于规律;
- 是否加载了页面附属资源(图片、CSS);
- 是否与页面有交互行为。
3. 人机验证
当置信度不足以判定时,用验证手段做二次确认:
| 验证方式 | 对用户的影响 | 适用场景 |
|---|---|---|
| JS 挑战 | 几乎无感(仅首次略慢) | 大部分不确定流量 |
| 滑块验证 | 需要手动拖动 | 高置信度可疑流量 |
| 短信/邮箱验证 | 干扰较大 | 极度敏感的操作 |
4. 分级响应
根据画像结果给出不同处置,这是 Bot 管理最核心的理念:
四、实际场景:内容站怎么用 Bot 管理
以内容站为例,常见的配置策略:
- 搜索引擎放行——验证真实 IP 后加白名单,确保收录不受影响;
- RSS 阅读器限速——可以抓取,但限制频率;
- 内容采集站重点拦截——尤其是那些原封不动搬运你内容的站点;
- 列表页与搜索页从严——这是被批量抓取的主要入口;
- 详情页可适度放宽——单页抓取的危害相对小。
进阶技巧:对疑似采集站返回带有隐藏标记的假内容,这样可以在后续发现对方的盗版来源,也是一种维权证据。
五、配置时的注意事项
- 先观察再拦截——开启几天观察模式,了解正常 Bot 流量构成;
- 白名单优先于黑名单——先确保该放行的能放行,再考虑拦谁;
- 注意 CDN 与代理场景——如果站点前面有其他代理层,要确保 WAF 能拿到真实客户端 IP;
- 定期复查——Bot 的 UA 和行为模式会变化,规则需要持续维护。
六、小结
Bot 管理相比普通爬虫防护的进步,本质上是把「非黑即白」变成了「精细化治理」。它承认了「机器流量不都是坏的」这个事实,通过分类分级实现精准处置——既保护了网站资源,又不误伤对业务有益的爬虫。对于内容型站点,这是一个投入产出比很高的功能。
